GEO 分數怎麼讀?從可見度到可信的判斷
理解分數統計了什麼、結果有多穩定,以及如何藉助研究方法,把一次排名轉化為有依據的業務判斷。

更新於
解讀 GEO 分數,要先看它統計的事件、背後的問題與樣本,以及回答的波動。提及、推薦、引用和造訪是不同的結果。GEO50 將已確認的品牌訊號彙整為特定觀察範圍內的排名;要解釋分數變化,還需要可比較的條件與原始證據。
關鍵要點
- 比較分數之前,先明確定義統計事件和分母。
- 結合重複回答與來源核查,判斷結果的可靠性。
- 把排名用於支持決策,不把它當成產品品質或內容修改效果的證明。
先明確定義分數要支持什麼決策
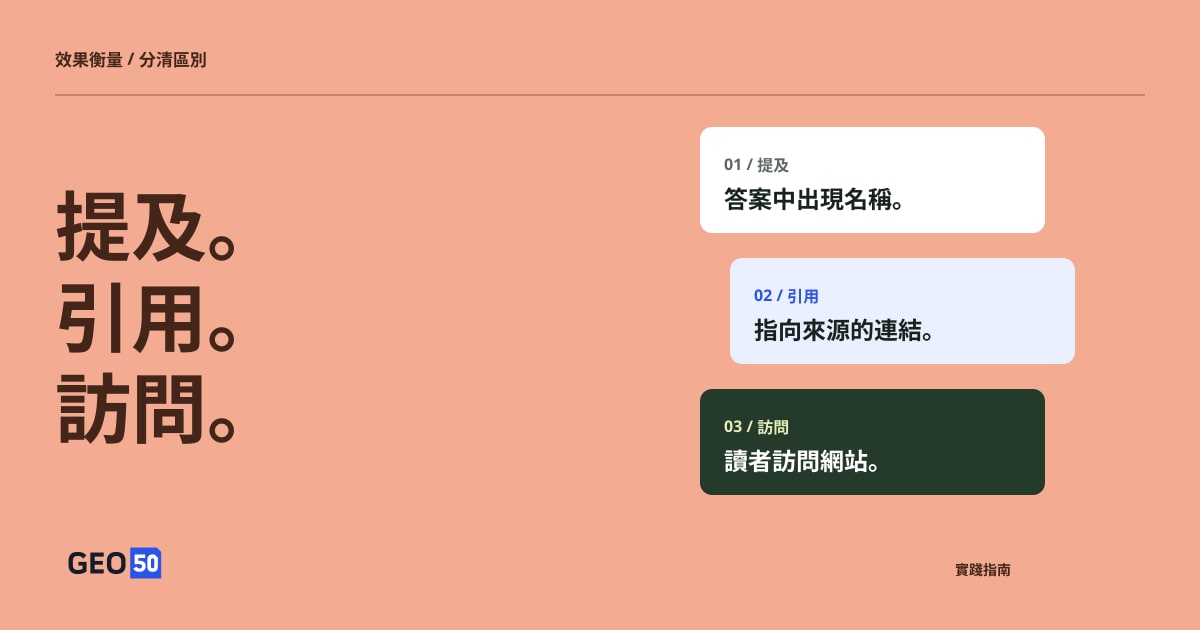
網站更新後,品牌分數提高了。最直接的反應是把這次更新視為成功。在下結論前,先看看答案究竟發生了什麼:品牌出現得更頻繁了,獲得了更強的推薦,還是增加了官網連結?這些是不同的改善。
有用的衡量始於具體問題,例如「在相關客戶需求下,AI 答案是否推薦我們的產品?」這個問題決定應蒐集哪些提問、統計什麼事件,以及怎樣的比較有意義。2026 年批判性綜述明確建議:蒐集資料前,先定義目標結果、分母,以及具有實際意義的差異。
分開理解出現、偏好與引用
答案說「Acme 是幾款行程工具之一」,可以確認一次提及;「Acme 適合這家代理商」,增加了一次推薦;「按這些需求,Acme 是我的首選」,則表達了更強的偏好。來源連結是另一種事件,可能指向公司官網、獨立評測,或競爭對手。
| 事件 | 證據需要顯示什麼 |
|---|---|
| 提及 | 答案中說出了品牌名稱 |
| 推薦 | 答案將品牌作為合適的選擇提出 |
| 首選 | 答案明確表達優先選擇該品牌 |
| 官網引用 | 連結指向公司自己的頁面 |
這也解釋了為什麼不能只看標題就比較研究成果。C-SEO Bench衡量的是引用順序變化,與品牌被提及或明確推薦的頻率不同。使用自動化報告時,應抽樣核對原始回答,確認標籤符合實際語意。URL 中包含品牌名稱,或產品位於清單第一項,都不足以證明答案明確將其列為首選。
檢查引用究竟支持了什麼
連結讓答案可以被檢查,卻不能證明頁面支持了對應主張。在 2023 年的生成式搜尋研究中,Liu、Zhang 和 Liang 稽核了 Bing Chat、NeevaAI、Perplexity 與 YouChat。在所評估系統中,平均 51.5% 的生成表述得到引用的完整支持,74.5% 的引用支持其對應表述。這些是歷史稽核結果,不是對今天平台準確率的估計。
兩個數字回答不同的問題。引用召回率關注需要核查的表述是否獲得完整來源支持;引用精確率關注所附引用是否支持答案所說的內容。兩者都需要檢查來源,不能透過數連結來判斷。
假設答案說一款產品支援離線使用,並包含免費入門培訓。確認離線功能的頁面只支持了其中一部分。在認為答案準確之前,還需要核查另一個主張、適用方案與日期。即使來源完整支持表述,也是在檢驗歸因,並不證明來源本身正確。對企業而言,實際要檢查的是自己的能力與限制是否在轉述中得到保留。
讓分母清楚可見
假設 20 次採集嘗試得到 16 份可用回答,其中 4 份引用了公司官網。可用回答中的引用率為 4/16,即 25%;採集成功率為 16/20,即 80%。這組假設數字描述的是兩件事。如果只報告「25% 可見度」,就掩蓋了採集失敗,也沒有說清統計的事件。
完整回答中沒有品牌,與請求失敗也不同。前者是觀察到沒有出現,後者是缺少證據。應分開記錄,並說明哪些觀察進入各項指標。
問題選擇同樣重要。「Acme 是一款好的行程工具嗎?」是在觀察對指定品牌的回應;「哪些工具適合小型代理商?」是在觀察品類中的自然發現。如果不加區分地混合,僅僅換一批問題就可能改變分數。生成的問題屬於測試集,並不衡量真實客戶提問的頻率。
接受答案之間會有波動
2026 年預印本《不要只測一次》透過跨時間觀察與重複採樣,研究了四個 AI 搜尋引擎。在其 24 小時內的來源分析中,四類業務主題的平均 Jaccard 重合度約為 32%–43%。Jaccard 重合度比較兩組來源的交集與聯集,不是品牌提及率,也不是答案正確的機率。
這部分分析對每個「引擎—提示詞」最多重複十次,並從來源比較中排除了沒有擷取到引用的執行結果。採集環境位於瑞士,選定領域和品牌辨識規則也限制了結論的推廣範圍。它提供的有用發現是:即使沒有間隔很長時間,也沒有修改網站,第二次回答仍可能與第一次明顯不同。
因此,需要分別做三種檢查:重複完全相同的問題,觀察執行波動;使用含義相同的不同問法,觀察措辭敏感性;跨時間重複固定問題集,觀察變化。能經受這三種檢查的結果,比一張有利截圖提供更多資訊。
GEO50 如何把品牌訊號彙整成分數
GEO50 彙整採樣所得單輪 AI 回答中已確認的品牌訊號。目前公式是我們的評分規則,並非本文所引論文規定的公式。網站引用、引薦造訪與引用品質不計入此分數。
| 訊號 | 分數貢獻 |
|---|---|
| 品牌出現在回答中 | 20 × 提及率 |
| 品牌獲得明確推薦 | 50 × 明確推薦率 |
| 品牌被明確列為首選 | 30 × 明確首選率 |
| 品牌被明確表示不推薦 | −50 × 明確不推薦率 |
各項比率取 0 到 1 之間的值,相加後將結果限制在 0–100 分。首選是推薦的子集,會獲得額外權重。清單順序、粗體或重複出現本身不能證明首選;同一回答包含一個品牌的多個產品,也不會重複加分。
以十份等權回答為假設:某品牌在全部十份中都只被中性提及,得分為 20。另一個品牌在三份中被推薦,其餘七份未出現,且從未被列為首選,得分為 21:20 × 0.3 + 50 × 0.3。差異體現了規則對推薦的重視,這兩個數字都不是購買機率。
重複樣本先在每個「問題—平台」組合內取平均,再對各組合等權彙整。未提到任何品牌的完整回答仍保留在分母中。只有全部計畫樣本均有效,並完成相容方法的分析後,才展示分數和名次。不完整採集不會被記為零分,前文 4/16 的引用例子也不代表可以據此生成 GEO50 排名。
含糊或相互矛盾的推薦保留為不確定判斷,不會被假定為正面或負面訊號。因此,分數彙整的是本規則下已確認的訊號,不是信賴水準、市占率估計或產品品質評分。

GEO50 目前的評分規則,已與實作核對。明確首選在推薦基礎上獲得額外權重;模糊訊號保留不確定判斷。這不是引用論文規定的評分公式。 檢視原圖。
在相同條件下比較觀察
只有比較條件一致,分數的高低才有解釋價值。綜述提出的研究方案結合了重複測量、同義問法、對照與人工核查。它還指出,回答會按問題、來源和日期形成群聚;把每份輸出都當成獨立的客戶偏好,可能低估不確定性。Martinez
企業報告可以保留一份簡潔的比較記錄:
| 維度 | 應保留的資訊 |
|---|---|
| 問題 | 完整措辭、客戶意圖與選取方法 |
| 條件 | 平台、產品介面、語言、目標市場和時間 |
| 樣本 | 各問題與平台的計畫數、可用數與失敗數 |
| 修改 | 頁面版本、修改日期,以及可行時保留的未修改對照 |
| 證據 | 原始回答、來源 URL 與自動判斷的核查記錄 |
先用小規模試測了解波動,再根據決策需要選擇採樣深度。如果不改善問題涵蓋範圍與採集一致性,只增加數量,仍可能得到誤導性結果。GEO50 目前的排名不展示統計信賴區間,也不證明某次修改的因果效果。
用排名決定下一步調查什麼
在相關客戶需求下表現較弱,可以提示我們檢查缺少的產品事實、模糊的定位,或更有說服力的競爭答案;表現較強,則可能幫助辨識值得持續維護的解釋。決定採取什麼行動前,應查看實際回答,並結合問題集與評分方法比較觀察。
把業務情境與技術上已驗證的條件分開。選擇某個市場,是在表達目標購買情境,本身並不重現當地使用者環境。Google 的 AI 功能流量包含在 Search Console 的整體網頁搜尋報告中,因此該總量不是獨立的 AI 引用次數。網站分析與客戶詢問可以進一步補充業務成果的證據。Google 搜尋中心
GEO50 展示觀察範圍與採集完整度,目前下載內容是已完成的榜單,並不包含完整回答檔案。可以用它找出值得檢查的模式,再沿著證據深入答案與客戶體驗。網站準備指南說明了如何把一個發現轉化為明確的內容改進。
參考來源與編輯說明
- Google 搜尋中心 — AI 功能與你的網站 ↗
Google AI Overviews 與 AI Mode 的官方指引;2026 年 10 月 18 日核對。屬於平台要求,不是實驗研究。
- Schulte、Bleeker 與 Kaufmann — Don’t Measure Once: Measuring Visibility in AI Search (GEO) ↗
2026 年預印本,arXiv v1,4 月 8 日。第 3–6 節:四個引擎的跨時間與重複採樣,以及來源/品牌重合度。瑞士採集環境、選定業務領域、子字串比對的品牌辨識和篩選規則限制了推廣範圍。
- Liu、Zhang 與 Liang — Evaluating Verifiability in Generative Search Engines ↗
Findings of EMNLP 2023;arXiv v2,2023 年 10 月 23 日。第 2.3–2.4 節、第 4.2 節及局限部分:引用召回率、引用精確率,以及來源支持與事實真實性的區別。屬於歷史稽核,不是目前的平台評分。
- Martinez — Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026) ↗
2026 年綜述預印本,arXiv v1,7 月 15 日。綜合 45 項研究;第 3、6、11 節區分處理階段、可見度結果和測量設計。用於理解研究脈絡,不作為獨立實驗驗證。
- Puerto 等 — C-SEO Bench: Does Conversational SEO Work? ↗
NeurIPS 2025,資料集與基準測試議程。第 4 節及第 6–7 節:兩類任務、六個領域、引用排序和競爭性採用。採用英語基準;上下文順序實驗不證明如何在實際引擎中取得該順序。