Pontuações GEO explicadas: o que o número pode informar
Entenda o que uma pontuação de visibilidade conta, sua estabilidade e como a investigação distingue ranking observado de conclusão comercial fiável.

Atualizado
Leia a pontuação GEO verificando o evento contado, perguntas e amostras e quanto as respostas variam. Menções, recomendações, citações e visitas descrevem resultados diferentes. O GEO50 combina sinais confirmados num ranking de observação definida; interpretar mudanças exige condições comparáveis e evidências subjacentes.
Principais conclusões
- Identifique evento e denominador antes de comparar pontuações.
- Use respostas repetidas e verificação de fontes para avaliar fiabilidade.
- Trate o ranking como evidência para decidir, não medida de qualidade nem efeito comprovado de uma edição.
Comece pela decisão que a pontuação deve apoiar
A pontuação de uma marca sobe após uma atualização do site. A tentação imediata é considerar a atualização bem-sucedida. Antes disso, pergunte o que mudou nas respostas: a marca apareceu mais, recebeu recomendações mais fortes ou ganhou links para o site? São melhorias diferentes.
Uma medição útil começa com uma pergunta como “As respostas relevantes de IA recomendam nosso produto para esta necessidade do cliente?”. Ela determina quais prompts recolher, qual evento contar e qual comparação importa. A revisão crítica de 2026 explicita isso: defina resultado desejado, denominador e diferença significativa antes de recolher dados.
Separe presença de preferência e citação
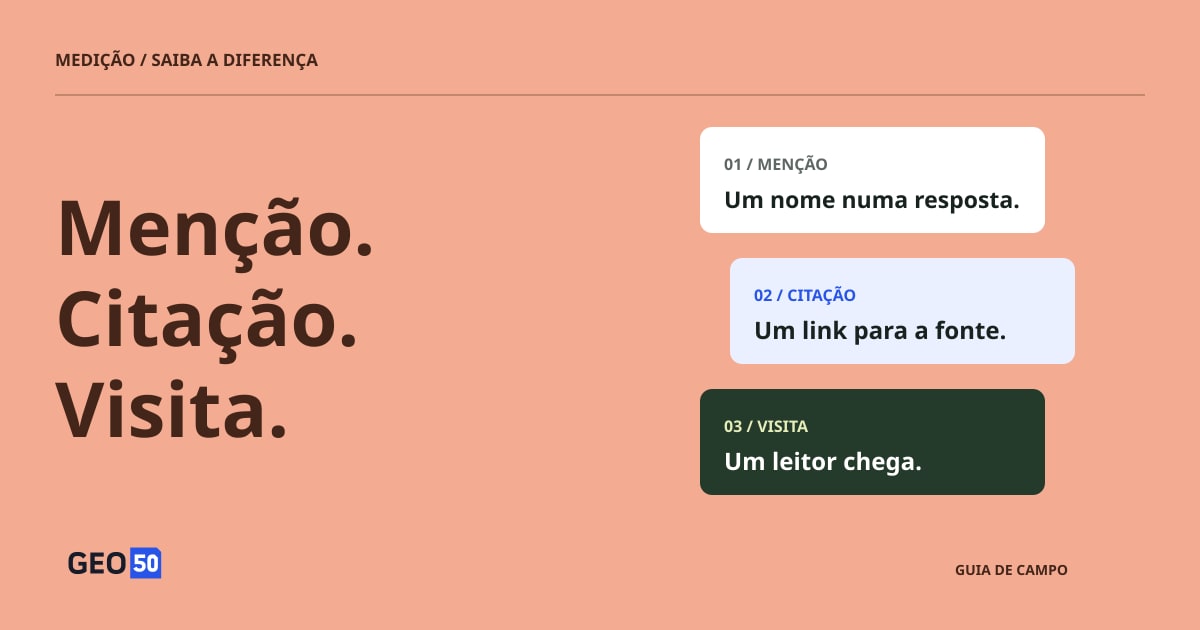
Uma resposta dizendo “Acme é uma entre várias ferramentas de agendamento” estabelece uma menção. “Acme é uma opção adequada para esta agência” acrescenta uma recomendação. “Acme é minha primeira escolha para estes requisitos” expressa preferência mais forte. Um link de fonte é outro evento e pode apontar para a empresa, uma avaliação independente ou um concorrente.
| Evento | O que a evidência precisa mostrar |
|---|---|
| Menção | A marca é nomeada na resposta |
| Recomendação | A resposta propõe a marca como opção adequada |
| Primeira escolha | A resposta a identifica explicitamente como melhor opção |
| Citação do site | Um link aponta para a página da própria empresa |
Isso também explica por que resultados de investigação não podem ser comparados apenas pelo título. O C-SEO Bench avalia mudanças na ordem das citações; é um resultado diferente da frequência de nomes ou recomendações explícitas. Em relatórios automatizados, examine uma amostra das respostas originais para verificar se os rótulos correspondem à linguagem. Nome de marca em URL ou produto no início de uma lista não basta para comprovar uma recomendação explícita como primeira escolha.
Confira o que uma citação realmente sustenta
Um link permite examinar uma resposta, mas não demonstra que a página apoia a afirmação. No estudo de 2023 sobre motores de pesquisa generativos, Liu, Zhang e Liang auditaram Bing Chat, NeevaAI, Perplexity e YouChat. Nos sistemas avaliados, 51.5% das afirmações geradas tinham apoio completo de citações, enquanto 74.5% das citações apoiavam suas afirmações associadas. São resultados históricos, não estimativas da precisão atual das plataformas.
As duas cifras respondem a perguntas diferentes. A cobertura das citações trata do apoio integral às afirmações que exigem verificação. A precisão trata de as citações anexadas sustentarem o que a resposta diz. Ambas exigem examinar fontes, não apenas contar links.
Suponha que uma resposta diga que um produto funciona offline e inclui integração inicial gratuita. Uma página que confirma uso offline apoia apenas parte da frase. Confira a outra afirmação, o plano aplicável e a data antes de considerar a resposta correta. Mesmo o apoio completo testa atribuição, não prova a verdade da própria fonte. Para a empresa, a revisão prática é saber se capacidades e condições sobrevivem à reformulação.
Torne o denominador visível
Imagine 20 tentativas de recolha produzindo 16 respostas utilizáveis, quatro delas citando o site da empresa. A taxa de citação nas respostas utilizáveis é 4/16, ou 25%; o sucesso da recolha é 16/20, ou 80%. As cifras hipotéticas descrevem coisas diferentes. Relatar apenas “25% de visibilidade” oculta falhas e não define o evento.
Uma resposta concluída sem menção à marca também difere de uma solicitação que falhou. A primeira é ausência observada; a segunda é falta de evidência. Registe separadamente e declare quais observações entram em cada métrica.
A seleção de perguntas importa tanto quanto isso. “Acme é uma boa ferramenta de agendamento?” testa reação a uma marca nomeada. “Quais ferramentas atendnuma agência pequena?” testa descoberta na categoria. Misturá-las sem distinção pode mudar a pontuação apenas pela troca das perguntas. Perguntas geradas formam um conjunto de teste; não medem a frequência com que clientes reais fazem cada pergunta.
Espere variação entre respostas
Don’t Measure Once, pré-publicação de 2026, examinou quatro motores de pesquisa com IA por observações ao longo do tempo e repetições. Na análise de fontes em até 24 horas, a sobreposição média de Jaccard variou de cerca de 32% a 43% nas quatro categorias de campanhas. Jaccard compara fontes partilhadas com a união dos dois conjuntos; não é taxa de menção nem probabilidade de acerto.
A análise usou até dez repetições por motor–prompt e excluiu da comparação de fontes execuções sem citações extraídas. O contexto da recolha foi suíço; setores escolhidos e regras de deteção de marcas limitam ainda mais a generalização. O achado útil é que uma segunda resposta pode diferir muito mesmo sem longo intervalo ou edição do site.
Isso sugere três verificações: repetir a mesma pergunta para examinar variação entre execuções, usar formulações equivalentes para testar sensibilidade ao texto e repetir um conjunto fixo ao longo do tempo para observar mudanças. Um resultado que supera as três informa mais do que uma captura de ecrã favorável.
Como o GEO50 transforma sinais de marca em pontuação
O GEO50 resume sinais de marca confirmados em respostas amostradas de IA de um único turno. A fórmula atual é nossa política de pontuação, não uma fórmula prescrita pelos estudos citados. Citações de sites, visitas de referência e qualidade das citações ficam fora dessa pontuação.
| Sinal | Contribuição |
|---|---|
| A marca aparece na resposta | 20 × taxa de menção |
| A marca é recomendada explicitamente | 50 × taxa de recomendação |
| A marca é explicitamente a primeira escolha | 30 × taxa de primeira escolha |
| A marca é explicitamente desaconselhada | −50 × taxa de não recomendação |
Use taxas de 0 a 1, some contribuições e limite o resultado a 0–100. Primeira escolha é subconjunto de recomendação e recebe peso adicional. Ordem da lista, negrito ou repetição sozinhos não estabelecem primeira escolha; vários produtos da mesma marca numa resposta não geram pontos extras.
Em dez respostas hipotéticas de mesmo peso, uma marca mencionada de forma neutra nas dez recebe 20. Uma recomendada em três, ausente em sete e nunca apontada como primeira escolha recebe 21: 20 × 0.3 + 50 × 0.3. A diferença reflete a ênfase da política na recomendação; nenhum número é probabilidade de compra.
Amostras repetidas são promediadas em cada combinação pergunta–plataforma, e as combinações recebem pesos iguais. Uma resposta completa sem marcas permanece no denominador. Todas as amostras previstas devem ser válidas e analisadas por método compatível antes de exibir posições e pontuações. Recolha incompleta não recebe zero; o exemplo anterior de citações 4/16 não qualifica uma observação para o ranking GEO50.
Recomendações ambíguas ou conflitantes mantêm julgamento incerto em vez de sinal positivo ou negativo presumido. A pontuação resume sinais confirmados nessa política. Não é nível de confiança, estimativa de participação de mercado nem nota de qualidade do produto.

Política atual de pontuação do GEO50, conferida com a implementação. Primeira escolha acrescenta peso à recomendação; sinais ambíguos permanecem incertos. A fórmula não é prescrita pelos estudos citados. Ver diagrama em tamanho original.
Compare observações nos mesmos termos
Uma pontuação maior informa quando a comparação preserva o significado da medida. O protocolo proposto pela revisão combina medições repetidas, paráfrases, controlos e validação humana. Também observa que respostas se agrupam por perguntas, fontes e datas: tratar toda saída como preferência independente pode subestimar a incerteza. Martinez
Para um relatório comercial, mantenha um registo compacto de comparação:
| Dimensão | O que manter visível |
|---|---|
| Perguntas | Texto exato, intenção do cliente e método de seleção |
| Condições | Plataforma, interface do produto, idioma, mercado pretendido e momento |
| Amostras | Observações previstas, utilizáveis e falhas por pergunta e plataforma |
| Mudança | Versões das páginas, data da intervenção e comparação sem intervenção quando viável |
| Evidências | Respostas originais, URLs de fontes e verificações dos julgamentos automatizados |
Use um piloto para avaliar variabilidade e escolher a profundidade de amostragem adequada à decisão. Aumentar a quantidade sem melhorar cobertura de perguntas ou consistência da recolha ainda pode enganar. O ranking atual do GEO50 não exibe intervalos de confiança estatísticos nem estabelece o efeito causal de uma edição.
Use o ranking para decidir o que investigar
Um resultado fraco para uma necessidade relevante pode apontar falta de factos do produto, posicionamento confuso ou respostas concorrentes mais fortes. Um resultado melhor pode revelar uma explicação que vale manter. Revise as respostas reais antes de agir e compare observações considerando perguntas e método de pontuação.
Separe contexto comercial do que foi tecnicamente verificado. Selecionar um mercado expressa o contexto de compra pretendido; não reproduz por si só o ambiente de um utilizador local. O tráfego dos recursos de IA do Google está incluído nos relatórios gerais de Web do Search Console; o total não é uma contagem independente de citações de IA. Análise do site e consultas de clientes acrescentam evidências sobre resultados comerciais. Google Search Central
O GEO50 mostra escopo e completude da recolha; o download atual contém o ranking completo, não o ficheiro integral de respostas. Use-o para localizar padrões que merecem exame e siga as evidências nas respostas e na experiência do cliente. Nosso guia de preparação do site explica como transformar um achado em melhoria definida de conteúdo.
Fontes e nota editorial
- Google Search Central — Recursos de IA e seu site ↗
Orientações oficiais para Google AI Overviews e AI Mode; verificadas em 18 de outubro de 2026. Requisitos de plataforma, não estudo experimental.
- Schulte, Bleeker e Kaufmann — Não meça uma só vez: medição da visibilidade na pesquisa com IA (GEO) ↗
Pré-publicação de 2026, arXiv v1, 8 de abril. Secções 3–6: sobreposição de fontes/marcas ao longo do tempo e em repetições em quatro motores. Contexto suíço, setores selecionados, deteção de marcas por substrings e filtragem limitam a generalização.
- Liu, Zhang e Liang — Avaliação da verificabilidade em motores de pesquisa generativos ↗
Findings of EMNLP 2023; arXiv v2, 23 de outubro de 2023. Secções 2.3–2.4 e 4.2 e Limitações: cobertura e precisão de citações e diferença entre apoio da fonte e verdade factual. Auditoria histórica, não avaliação atual de plataformas.
- Martinez — Otimização da visibilidade em motores generativos: revisão crítica de GEO (2023–2026) ↗
Pré-publicação de revisão de 2026, arXiv v1, 15 de julho. Síntese de 45 estudos; secções 3, 6 e 11 distinguem etapas do processo, resultados de visibilidade e desenho da medição. Use como síntese de investigação, não confirmação experimental independente.
- Puerto et al. — C-SEO Bench: o SEO conversacional funciona? ↗
NeurIPS 2025, área Datasets and Benchmarks. Secções 4 e 6–7: duas tarefas, seis domínios, ordem das citações e adoção por concorrentes. Benchmark em inglês; experimentos de ordem do contexto não demonstram como obter essa ordem num motor real.