GEO-poäng förklarade: vad talet kan säga
Förstå vad en synlighetspoäng räknar, hur stabil den är och hur forskning skiljer en observerad rankning från en tillförlitlig affärsslutsats.

Uppdaterad
Läs en GEO-poäng genom att kontrollera händelsen den räknar, frågorna och stickproven bakom den samt hur mycket svaren varierar. Omnämnanden, rekommendationer, källhänvisningar och besök beskriver olika utfall. GEO50 kombinerar bekräftade varumärkessignaler till en rankning för en definierad observation; tolkning av förändring kräver också jämförbara villkor och underliggande underlag.
Viktiga slutsatser
- Identifiera händelse och nämnare innan du jämför poäng.
- Använd upprepade svar och källkontroller för att bedöma tillförlitligheten.
- Se rankningen som beslutsunderlag, inte som produktkvalitet eller bevisad effekt av en ändring.
Börja med beslutet som poängen ska stödja
Ett varumärkes poäng stiger efter en webbplatsuppdatering. Den omedelbara frestelsen är att kalla uppdateringen framgångsrik. Fråga först vad som förändrades i svaren: syntes varumärket oftare, fick det starkare rekommendationer eller länkar till webbplatsen? Det är olika förbättringar.
En användbar mätning börjar med en fråga som ”Rekommenderar relevanta AI-svar vår produkt för detta kundbehov?”. Frågan avgör vilka instruktioner som samlas in, vilken händelse som räknas och vilken jämförelse som är viktig. Den kritiska översikten från 2026 är tydlig: definiera avsett utfall, nämnare och meningsfull skillnad före datainsamling.
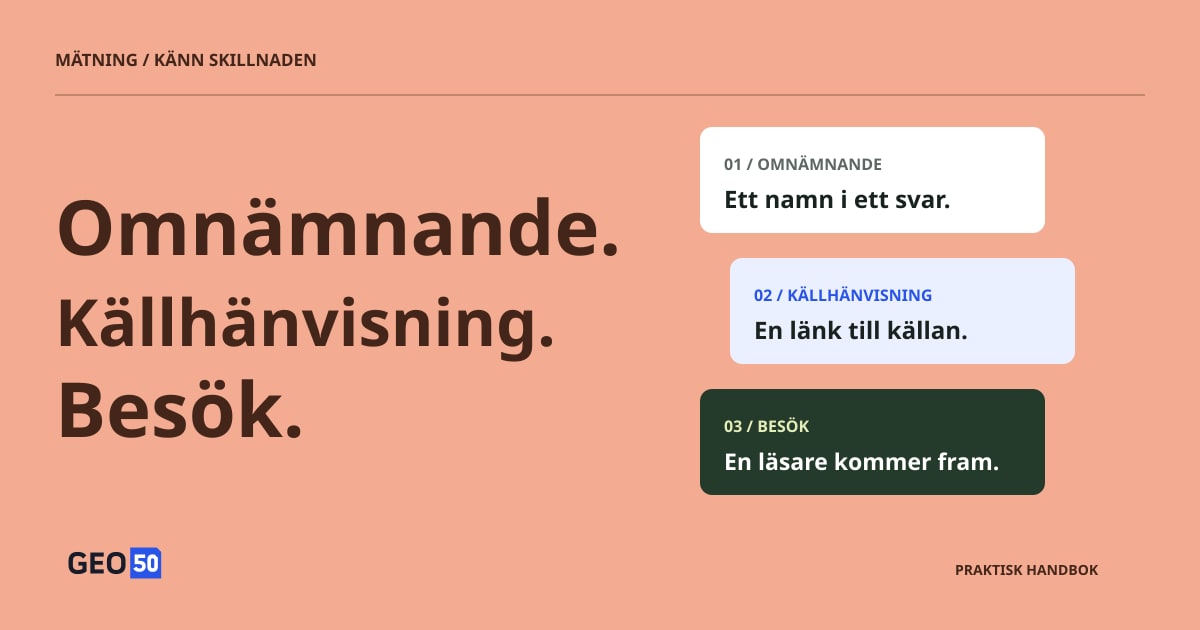
Skilj närvaro från preferens och källhänvisning
Svaret ”Acme är ett av flera bokningsverktyg” ger ett omnämnande. ”Acme är ett lämpligt val för denna byrå” lägger till en rekommendation. ”Acme är mitt förstahandsval för dessa krav” uttrycker en starkare preferens. En källänk är en separat händelse och kan gå till företaget, en oberoende recension eller en konkurrent.
| Händelse | Vad underlaget måste visa |
|---|---|
| Omnämnande | Varumärket namnges i svaret |
| Rekommendation | Svaret föreslår varumärket som ett lämpligt val |
| Förstahandsval | Svaret anger uttryckligen att det är det främsta valet |
| Webbplatshänvisning | En länk går till företagets egen sida |
Skillnaden förklarar också varför forskningsresultat inte kan jämföras bara utifrån rubriken. C-SEO Bench utvärderar förändringar i källornas ordning; det skiljer sig från hur ofta ett varumärke namnges eller uttryckligen rekommenderas. Granska ett urval originalsvar i en automatisk rapport så att etiketterna stämmer med språket. Ett varumärkesnamn i en URL eller en produkt först i en lista räcker inte som bevis för ett uttryckligt förstahandsval.
Kontrollera vad en källhänvisning faktiskt stödjer
En länk gör svaret granskningsbart men bevisar inte att sidan stödjer påståendet. I studien av generativa sökmotorer från 2023 granskade Liu, Zhang och Liang Bing Chat, NeevaAI, Perplexity och YouChat. I de utvärderade systemen stöddes 51.5% av genererade påståenden helt av källhänvisningar, medan 74.5% av hänvisningarna stödde sina tillhörande påståenden. Det är historiska granskningsresultat, inte uppskattningar av dagens plattformsprecision.
Talen besvarar olika frågor. Källhänvisningarnas täckning gäller om påståenden som behöver verifieras har fullt källstöd. Precisionen gäller om de bifogade källorna stödjer vad svaret säger. Båda kräver källgranskning, inte bara länkräkning.
Anta att ett svar säger att en produkt fungerar offline och inkluderar kostnadsfri introduktion. En sida som bekräftar offlineanvändning stödjer bara en del av meningen. Kontrollera det andra påståendet, tillämplig plan och datum innan svaret betraktas som korrekt. Även fullständigt källstöd testar attribution, inte om källan själv är sann. För företag är den praktiska frågan om möjligheter och villkor överlever återberättandet.
Gör nämnaren synlig
Tänk dig att 20 insamlingsförsök ger 16 användbara svar, varav fyra länkar till företagets webbplats. Hänvisningsandelen bland användbara svar är 4/16, eller 25%; insamlingsframgången är 16/20, eller 80%. Dessa hypotetiska tal beskriver olika saker. Att bara rapportera ”25% synlighet” döljer insamlingsfel och lämnar händelsen odefinierad.
Ett fullständigt svar utan varumärkesomnämnande skiljer sig också från en misslyckad begäran. Det första är observerad frånvaro; det andra är saknat underlag. Registrera dem separat och ange vilka observationer som ingår i varje mått.
Frågeurvalet är lika viktigt. ”Är Acme ett bra bokningsverktyg?” testar reaktionen på ett namngivet varumärke. ”Vilka verktyg passar en liten byrå?” testar upptäckt inom kategorin. Att blanda dem utan åtskillnad kan ändra poängen enbart genom ändrade frågor. Genererade frågor är ett testurval; de mäter inte hur ofta verkliga kunder ställer varje fråga.
Räkna med variation mellan svar
Don’t Measure Once, ett förhandspublicerat manus från 2026, undersökte fyra AI-sökmotorer genom observationer över tid och upprepade körningar. I källanalysen inom 24 timmar låg genomsnittlig Jaccard-överlappning omkring 32% till 43% över de fyra kampanjkategorierna. Jaccard-överlappning jämför gemensamma källor med unionen av två källmängder; det är inte ett varumärkes omnämnandeandel eller sannolikheten att svaret är rätt.
Analysen använde upp till tio upprepningar per motor–fråga och uteslöt körningar utan extraherade källhänvisningar från källjämförelsen. Insamlingskontexten var schweizisk, och utvalda sektorer samt regler för varumärkesidentifiering begränsar generalisering ytterligare. Det användbara fyndet är att ett andra svar kan skilja sig kraftigt även utan långt tidsintervall eller en webbplatsändring.
Det motiverar tre separata kontroller: upprepa samma fråga för att undersöka körningsvariation, använd likvärdiga formuleringar för att undersöka språkkänslighet och upprepa ett fast frågeurval över tid för att undersöka förändring. Ett resultat som består genom alla tre är mer informativt än en gynnsam skärmbild.
Så omvandlar GEO50 varumärkessignaler till poäng
GEO50 sammanfattar bekräftade varumärkessignaler i insamlade AI-svar från en enda samtalstur. Nuvarande formel är vår poängpolicy, inte en formel föreskriven av de citerade studierna. Webbplatshänvisningar, hänvisningsbesök och hänvisningarnas kvalitet ingår inte i poängen.
| Signal | Bidrag |
|---|---|
| Varumärket finns i svaret | 20 × omnämnandeandel |
| Varumärket rekommenderas uttryckligen | 50 × rekommendationsandel |
| Varumärket är uttryckligt förstahandsval | 30 × förstahandsvalsandel |
| Varumärket avråds uttryckligen | −50 × avrådandeandel |
Använd andelar från 0 till 1, summera bidragen och begränsa resultatet till 0–100. Förstahandsval är en delmängd av rekommendationer och får extra vikt. Listordning, fetstil eller upprepning ensam fastställer inte förstahandsval, och flera produkter från samma varumärke i ett svar ger inga extra poäng.
För tio hypotetiska, lika viktade svar får ett varumärke som nämns neutralt i alla tio 20 poäng. Ett varumärke som rekommenderas i tre, saknas i sju och aldrig anges som förstahandsval får 21: 20 × 0.3 + 50 × 0.3. Skillnaden speglar policyns fokus på rekommendation; inget tal är en köpsannolikhet.
Upprepade stickprov medelvärdesbildas inom varje fråga–plattform-kombination, och kombinationerna får lika vikt. Ett fullständigt svar utan namngivna varumärken finns kvar i nämnaren. Alla planerade stickprov måste vara giltiga och analyserade med en kompatibel metod innan poäng och placering visas. Ofullständig insamling får inte noll, och exemplet med 4/16 hänvisningar kvalificerar inte en observation för GEO50-rankning.
Tvetydiga eller motsägelsefulla rekommendationer behåller en osäker bedömning i stället för en antagen positiv eller negativ signal. Poängen sammanfattar alltså bekräftade signaler enligt policyn. Den är inte en konfidensnivå, uppskattad marknadsandel eller bedömning av produktkvalitet.

GEO50:s nuvarande poängpolicy, kontrollerad mot implementeringen. Förstahandsval ger extra vikt till en rekommendation; tvetydiga signaler förblir osäkra. Formeln är inte föreskriven av de citerade studierna. Visa diagrammet i full storlek.
Jämför observationer på samma villkor
En högre poäng blir informativ när jämförelsen bevarar mätningens innebörd. Översiktens föreslagna forskningsprotokoll kombinerar upprepade mätningar, omformuleringar, kontroller och mänsklig validering. Det påpekar också att svar är grupperade efter frågor, källor och datum: att behandla varje utdata som en oberoende kundpreferens kan underskatta osäkerheten. Martinez
Behåll ett kortfattat jämförelseunderlag i affärsrapporten:
| Dimension | Gör detta synligt |
|---|---|
| Frågor | Exakt formulering, kundavsikt och urvalsmetod |
| Villkor | Plattform, produktgränssnitt, språk, avsedd marknad och tid |
| Stickprov | Planerade, användbara och misslyckade observationer per fråga och plattform |
| Förändring | Sidversioner, interventionsdatum och om möjligt en obehandlad jämförelse |
| Underlag | Originalsvar, käll-URL:er och kontroller av automatiska bedömningar |
Använd en pilot för att bedöma variation och välja insamlingsdjup för beslutet. Fler svar utan bättre frågetäckning eller konsekvent insamling kan fortfarande ge ett missvisande resultat. GEO50:s nuvarande rankning visar inga statistiska konfidensintervall och fastställer inte en ändrings kausala effekt.
Använd rankningen för att välja vad du ska undersöka
Ett svagt resultat för ett relevant kundbehov kan rikta uppmärksamhet mot saknade produktfakta, otydlig positionering eller starkare konkurrerande svar. Ett starkare resultat kan visa en förklaring värd att behålla. Granska faktiska svar innan nästa åtgärd väljs och jämför observationer med frågeurval och poängmetod i åtanke.
Håll affärskontexten separat från det tekniskt verifierade. Val av marknad anger avsedd köpkontext; det återskapar inte i sig en lokal användares miljö. Trafik från Googles AI-funktioner ingår i den samlade webbrapporteringen i Search Console, så totalsiffran är inte ett separat antal AI-hänvisningar. Webbplatsanalys och kundförfrågningar ger ytterligare underlag om affärsutfall. Google Search Central
GEO50 visar observationens omfattning och insamlingens fullständighet, och den nuvarande nedladdningen innehåller den färdiga rankningen snarare än hela svarsarkivet. Använd den för att hitta mönster att undersöka och följ sedan underlaget till svar och kundupplevelse. Vår guide till webbplatsförberedelser förklarar hur ett fynd blir en definierad innehållsförbättring.
Källor och redaktionell kommentar
- Google Search Central — AI-funktioner och din webbplats ↗
Officiell vägledning för Google AI Overviews och AI Mode; kontrollerad 18 oktober 2026. Plattformskrav, inte en experimentell studie.
- Schulte, Bleeker och Kaufmann — Mät inte en gång: att mäta synlighet i AI-sökning (GEO) ↗
Förhandsmanus 2026, arXiv v1, 8 april. Avsnitt 3–6: käll- och varumärkesöverlappning över tid och upprepade körningar i fyra motorer. Schweizisk insamlingskontext, utvalda kampanjområden, delsträngsbaserad varumärkesidentifiering och filtrering begränsar generalisering.
- Liu, Zhang och Liang — Utvärdering av verifierbarhet i generativa sökmotorer ↗
Findings of EMNLP 2023; arXiv v2, 23 oktober 2023. Avsnitt 2.3–2.4 och 4.2 samt begränsningar: källhänvisningars täckning, precision och skillnaden mellan källstöd och faktisk sanning. Historisk granskning, inte ett aktuellt plattformsbetyg.
- Martinez — Optimering av synlighet i generativa motorer: en kritisk översikt av GEO (2023–2026) ↗
Förhandsmanus till översikt 2026, arXiv v1, 15 juli. Syntes av 45 studier; avsnitt 3, 6 och 11 skiljer processsteg, synlighetsutfall och mätningsupplägg. Använd som forskningssyntes, inte oberoende experimentell bekräftelse.
- Puerto med flera — C-SEO Bench: fungerar konversations-SEO? ↗
NeurIPS 2025, Datasets and Benchmarks-spåret. Avsnitt 4 och 6–7: två uppgifter, sex områden, källordning och konkurrerande användare. Engelskspråkigt jämförelsetest; experiment med kontextordning visar inte hur ordningen kan uppnås i en verklig sökmotor.