Baca versi asli bahasa Inggris ↗
Memahami skor GEO: apa yang dapat dijelaskan angkanya
Pahami apa yang dihitung skor visibilitas, kestabilannya, dan bagaimana riset membantu membedakan peringkat teramati dari kesimpulan bisnis yang andal.

Diperbarui
Baca skor GEO dengan memeriksa peristiwa yang dihitung, pertanyaan dan sampel di baliknya, serta variasi jawaban. Penyebutan, rekomendasi, kutipan, dan kunjungan menggambarkan hasil berbeda. GEO50 menggabungkan sinyal merek terkonfirmasi menjadi peringkat untuk pengamatan terdefinisi; menafsirkan perubahan juga memerlukan kondisi sebanding dan bukti yang mendasarinya.
Hal yang perlu diingat
- Identifikasi peristiwa dan penyebut sebelum membandingkan skor.
- Gunakan jawaban berulang dan pemeriksaan sumber untuk menilai keandalan.
- Perlakukan peringkat sebagai bukti untuk mengambil keputusan, bukan ukuran kualitas produk atau efek penyuntingan yang telah terbukti.
Mulai dari keputusan yang harus didukung skor
Skor merek naik setelah pembaruan situs. Godaan langsungnya adalah menyebut pembaruan itu berhasil. Sebelum melakukannya, tanyakan perubahan dalam jawaban yang mendasari: apakah merek lebih sering muncul, menerima rekomendasi lebih kuat, atau memperoleh tautan ke situsnya? Itu adalah perbaikan berbeda.
Pengukuran berguna berawal dari pertanyaan seperti “Apakah jawaban AI yang relevan merekomendasikan produk kita untuk kebutuhan pelanggan ini?” Pertanyaan menentukan prompt yang dikumpulkan, peristiwa yang dihitung, dan perbandingan yang bermakna. Survei kritis 2026 menegaskan: tentukan hasil tujuan, penyebut, dan perbedaan yang bermakna sebelum mengumpulkan data.
Pisahkan kehadiran dari preferensi dan kutipan
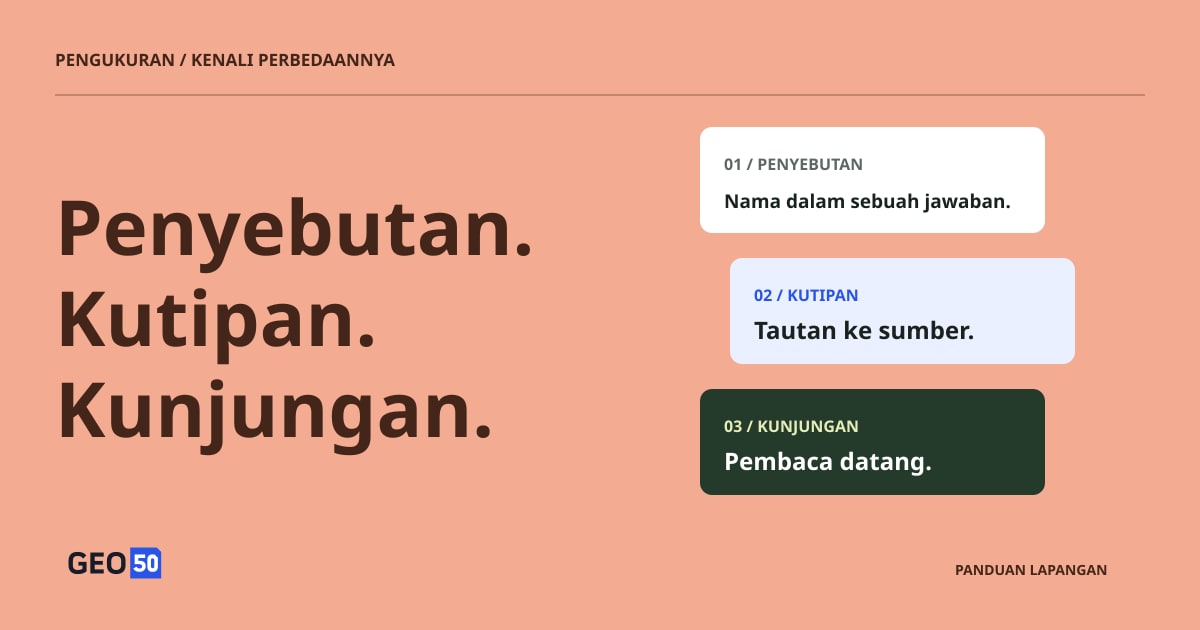
Jawaban “Acme adalah salah satu dari beberapa alat penjadwalan” menunjukkan penyebutan. “Acme adalah pilihan yang cocok untuk agensi ini” menambahkan rekomendasi. “Acme adalah pilihan pertama saya untuk kebutuhan ini” menunjukkan preferensi lebih kuat. Tautan sumber adalah peristiwa terpisah dan dapat menuju perusahaan, ulasan independen, atau pesaing.
| Peristiwa | Yang harus ditunjukkan bukti |
|---|---|
| Penyebutan | Nama merek disebut dalam jawaban |
| Rekomendasi | Jawaban mengusulkan merek sebagai pilihan yang cocok |
| Pilihan pertama | Jawaban secara eksplisit menempatkannya sebagai pilihan utama |
| Kutipan situs | Tautan menuju halaman perusahaan sendiri |
Perbedaan ini juga menjelaskan mengapa hasil riset tidak dapat dibandingkan dari judul saja. C-SEO Bench mengevaluasi perubahan urutan kutipan; hasil itu berbeda dari frekuensi nama merek disebut atau direkomendasikan secara eksplisit. Dalam laporan otomatis, tinjau sampel jawaban asli untuk memastikan label cocok dengan bahasanya. Nama merek dalam URL atau produk di urutan pertama daftar tidak cukup membuktikan rekomendasi eksplisit sebagai pilihan pertama.
Periksa apa yang benar-benar didukung kutipan
Tautan membuat jawaban dapat diperiksa, tetapi tidak membuktikan halaman tertaut mendukung klaim. Dalam studi mesin pencarian generatif tahun 2023, Liu, Zhang, dan Liang mengaudit Bing Chat, NeevaAI, Perplexity, dan YouChat. Di seluruh sistem yang dievaluasi, 51.5% pernyataan yang dihasilkan didukung sepenuhnya oleh kutipan, sedangkan 74.5% kutipan mendukung pernyataan terkait. Ini hasil audit historis, bukan perkiraan akurasi platform saat ini.
Kedua angka menjawab pertanyaan berbeda. Cakupan kutipan membahas apakah pernyataan yang perlu diverifikasi memiliki dukungan sumber penuh. Ketepatan kutipan membahas apakah kutipan terlampir mendukung isi jawaban. Keduanya membutuhkan pemeriksaan sumber, bukan sekadar menghitung tautan.
Misalkan jawaban mengatakan produk bekerja luring dan mencakup pendampingan awal gratis. Halaman yang mengonfirmasi penggunaan luring hanya mendukung sebagian kalimat. Periksa klaim lainnya, paket yang berlaku, dan tanggal sebelum menganggap jawaban akurat. Bahkan dukungan sumber penuh adalah uji atribusi, bukan bukti sumber itu sendiri benar. Bagi bisnis, pemeriksaan praktisnya adalah apakah kemampuan dan syarat tetap utuh saat diceritakan kembali.
Tampilkan penyebutnya
Bayangkan 20 percobaan pengumpulan menghasilkan 16 jawaban layak pakai, empat di antaranya mengutip situs perusahaan. Tingkat kutipan di antara jawaban layak adalah 4/16, atau 25%; keberhasilan pengumpulan adalah 16/20, atau 80%. Angka hipotetis ini menggambarkan dua hal berbeda. Melaporkan “visibilitas 25%” saja menyembunyikan kegagalan pengumpulan dan membiarkan peristiwanya tidak terdefinisi.
Jawaban selesai tanpa penyebutan merek juga berbeda dari permintaan gagal. Yang pertama adalah ketiadaan yang diamati; yang kedua adalah bukti yang hilang. Catat terpisah dan jelaskan pengamatan mana masuk ke setiap metrik.
Pemilihan pertanyaan sama pentingnya. “Apakah Acme alat penjadwalan yang bagus?” menguji respons terhadap merek yang disebut. “Alat apa yang cocok untuk agensi kecil?” menguji penemuan dalam kategori. Mencampurkannya tanpa pembedaan dapat mengubah skor hanya karena pertanyaannya berubah. Pertanyaan yang dihasilkan membentuk kumpulan uji; bukan ukuran seberapa sering pelanggan nyata menanyakan setiap pertanyaan.
Harapkan variasi antarjawaban
Don’t Measure Once, pracetak 2026, memeriksa empat mesin pencarian AI melalui pengamatan dari waktu ke waktu dan pengulangan. Dalam analisis sumber dalam 24 jam, rata-rata irisan Jaccard berkisar sekitar 32% hingga 43% di empat kategori kampanye. Irisan Jaccard membandingkan sumber bersama dengan gabungan dua kumpulan sumber; bukan tingkat penyebutan merek atau probabilitas jawaban benar.
Analisis menggunakan hingga sepuluh pengulangan per pasangan mesin–prompt dan mengecualikan proses tanpa kutipan yang berhasil diekstrak dari perbandingan sumber tersebut. Konteks pengumpulan berada di Swiss, dan sektor terpilih serta aturan deteksi merek semakin membatasi generalisasi. Temuan bergunanya adalah jawaban kedua dapat berbeda secara substansial meski tanpa selang waktu panjang atau penyuntingan situs.
Ini menyarankan tiga pemeriksaan terpisah: ulangi pertanyaan identik untuk memeriksa variasi antarproses, gunakan susunan setara untuk memeriksa sensitivitas kata, dan ulangi kumpulan pertanyaan tetap dari waktu ke waktu untuk memeriksa perubahan. Hasil yang bertahan dalam ketiganya lebih informatif daripada satu tangkapan layar yang menguntungkan.
Cara GEO50 mengubah sinyal merek menjadi skor
GEO50 merangkum sinyal merek terkonfirmasi dalam sampel jawaban AI satu putaran. Rumus saat ini adalah kebijakan penilaian kami, bukan rumus yang ditetapkan makalah yang dikutip di sini. Kutipan situs, kunjungan rujukan, dan kualitas kutipan berada di luar skor ini.
| Sinyal | Kontribusi |
|---|---|
| Merek muncul dalam jawaban | 20 × tingkat penyebutan |
| Merek direkomendasikan secara eksplisit | 50 × tingkat rekomendasi |
| Merek secara eksplisit menjadi pilihan pertama | 30 × tingkat pilihan pertama |
| Merek secara eksplisit tidak direkomendasikan | −50 × tingkat tidak direkomendasikan |
Gunakan tingkat antara 0 dan 1, jumlahkan kontribusinya, lalu batasi hasil pada 0–100. Pilihan pertama merupakan bagian dari rekomendasi dan menerima bobot tambahan. Urutan daftar, teks tebal, atau pengulangan saja tidak membuktikan pilihan pertama; beberapa produk dari merek sama dalam satu jawaban tidak mendapat poin tambahan.
Untuk sepuluh jawaban hipotetis berbobot sama, merek yang disebut netral pada semuanya mendapat skor 20. Merek yang direkomendasikan pada tiga jawaban, tidak muncul pada tujuh, dan tidak pernah menjadi pilihan pertama mendapat 21: 20 × 0.3 + 50 × 0.3. Perbedaan ini mencerminkan penekanan kebijakan skor pada rekomendasi; kedua angka bukan probabilitas pembelian.
Sampel berulang dirata-ratakan dalam setiap pasangan pertanyaan–platform, lalu pasangan-pasangan itu mendapat bobot sama. Jawaban lengkap tanpa merek tetap masuk penyebut. Semua sampel terencana harus valid dan dianalisis dengan metode kompatibel sebelum skor dan posisi ditampilkan. Pengumpulan tidak lengkap tidak diberi nol, dan contoh kutipan 4/16 sebelumnya tidak memenuhi syarat pengamatan untuk peringkat GEO50.
Rekomendasi ambigu atau bertentangan mempertahankan penilaian tidak pasti, bukan asumsi sinyal positif atau negatif. Karena itu, skor merangkum sinyal terkonfirmasi menurut kebijakan ini. Skor bukan tingkat keyakinan, estimasi pangsa pasar, atau penilaian kualitas produk.

Kebijakan penilaian GEO50 saat ini, diperiksa terhadap implementasi. Pilihan pertama menambah bobot pada rekomendasi; sinyal ambigu tetap tidak pasti. Ini bukan rumus yang ditetapkan makalah rujukan. Lihat diagram ukuran penuh.
Bandingkan pengamatan dengan dasar yang sama
Skor lebih tinggi menjadi informatif ketika perbandingan mempertahankan makna pengukuran. Protokol riset yang diusulkan survei menggabungkan pengukuran berulang, parafrasa, kontrol, dan validasi manusia. Survei juga mencatat jawaban mengelompok menurut pertanyaan, sumber, dan tanggal: memperlakukan setiap keluaran sebagai preferensi pelanggan independen dapat meremehkan ketidakpastian. Martinez
Untuk laporan bisnis, simpan catatan perbandingan ringkas:
| Dimensi | Yang tetap ditampilkan |
|---|---|
| Pertanyaan | Susunan persis, maksud pelanggan, dan metode pemilihan |
| Kondisi | Platform, antarmuka produk, bahasa, pasar tujuan, dan waktu |
| Sampel | Pengamatan terencana, layak pakai, dan gagal untuk setiap pertanyaan dan platform |
| Perubahan | Versi halaman, tanggal intervensi, dan pembanding tanpa perlakuan jika memungkinkan |
| Bukti | Jawaban asli, URL sumber, dan pemeriksaan penilaian otomatis |
Gunakan uji pendahuluan untuk menilai variasi dan memilih kedalaman sampel sesuai keputusan. Menambah jumlah tanpa memperbaiki cakupan pertanyaan atau konsistensi pengumpulan tetap dapat menghasilkan kesimpulan menyesatkan. Peringkat GEO50 saat ini tidak menampilkan interval kepercayaan statistik atau membuktikan efek kausal penyuntingan.
Gunakan peringkat untuk menentukan apa yang perlu diselidiki
Hasil lemah pada kebutuhan pelanggan relevan dapat mengarahkan perhatian ke fakta produk yang hilang, posisi tidak jelas, atau jawaban pesaing yang lebih kuat. Hasil lebih kuat dapat mengidentifikasi penjelasan yang layak dipertahankan. Tinjau jawaban sebenarnya sebelum menentukan tindakan, dan bandingkan pengamatan dengan tetap memperhatikan kumpulan pertanyaan serta metode skornya.
Pisahkan konteks bisnis dari yang diverifikasi secara teknis. Memilih pasar menyatakan konteks pembelian tujuan; tidak otomatis mereproduksi lingkungan pengguna lokal. Trafik fitur AI Google termasuk dalam pelaporan Web keseluruhan di Search Console, sehingga totalnya bukan hitungan kutipan AI tersendiri. Analitik situs dan pertanyaan pelanggan menambah bukti hasil bisnis. Google Search Central
GEO50 menunjukkan cakupan pengamatan dan kelengkapan pengumpulan, dan unduhan saat ini berisi peringkat lengkap, bukan seluruh arsip jawaban. Gunakan untuk menemukan pola yang layak diperiksa, lalu ikuti bukti ke jawaban dan pengalaman pelanggan. Panduan persiapan situs menjelaskan cara mengubah temuan menjadi perbaikan konten yang terdefinisi.
Sumber dan catatan editorial
- Google Search Central — Fitur AI dan situs web Anda ↗
Panduan resmi Google AI Overviews dan AI Mode; diperiksa 18 Oktober 2026. Persyaratan platform, bukan studi eksperimen.
- Schulte, Bleeker, dan Kaufmann — Jangan Mengukur Sekali Saja: Mengukur Visibilitas dalam Pencarian AI (GEO) ↗
Pracetak 2026, arXiv v1, 8 April. Bagian 3–6: irisan sumber/merek secara longitudinal dan pada pengulangan di empat mesin. Konteks pengumpulan Swiss, sektor kampanye terpilih, deteksi merek berbasis substring, dan penyaringan membatasi generalisasi.
- Liu, Zhang, dan Liang — Mengevaluasi Keterverifikasian dalam Mesin Pencarian Generatif ↗
Findings of EMNLP 2023; arXiv v2, 23 Oktober 2023. Bagian 2.3–2.4 dan 4.2, serta Keterbatasan: cakupan kutipan, ketepatan kutipan, dan perbedaan dukungan sumber dengan kebenaran faktual. Audit historis, bukan kartu nilai platform saat ini.
- Martinez — Mengoptimalkan Visibilitas dalam Mesin Generatif: Survei Kritis Optimasi Mesin Generatif (2023–2026) ↗
Pracetak survei 2026, arXiv v1, 15 Juli. Sintesis 45 studi; Bagian 3, 6, dan 11 membedakan tahap alur, hasil visibilitas, dan rancangan pengukuran. Gunakan sebagai sintesis riset, bukan konfirmasi eksperimen independen.
- Puerto dkk. — C-SEO Bench: Apakah SEO Percakapan Berhasil? ↗
NeurIPS 2025, Datasets and Benchmarks Track. Bagian 4 dan 6–7: dua tugas, enam ranah, urutan kutipan, dan pesaing yang mengadopsi metode. Tolok ukur berbahasa Inggris; eksperimen urutan konteks tidak menunjukkan cara memperoleh urutan tersebut pada mesin yang beroperasi langsung.