GEO-poengsummer forklart: Hva tallet kan fortelle deg
Forstå hva en synlighetspoengsum teller, hvor stabil den er, og hvordan forskning hjelper deg å skille en observert rangering fra en pålitelig forretningskonklusjon.

Oppdatert
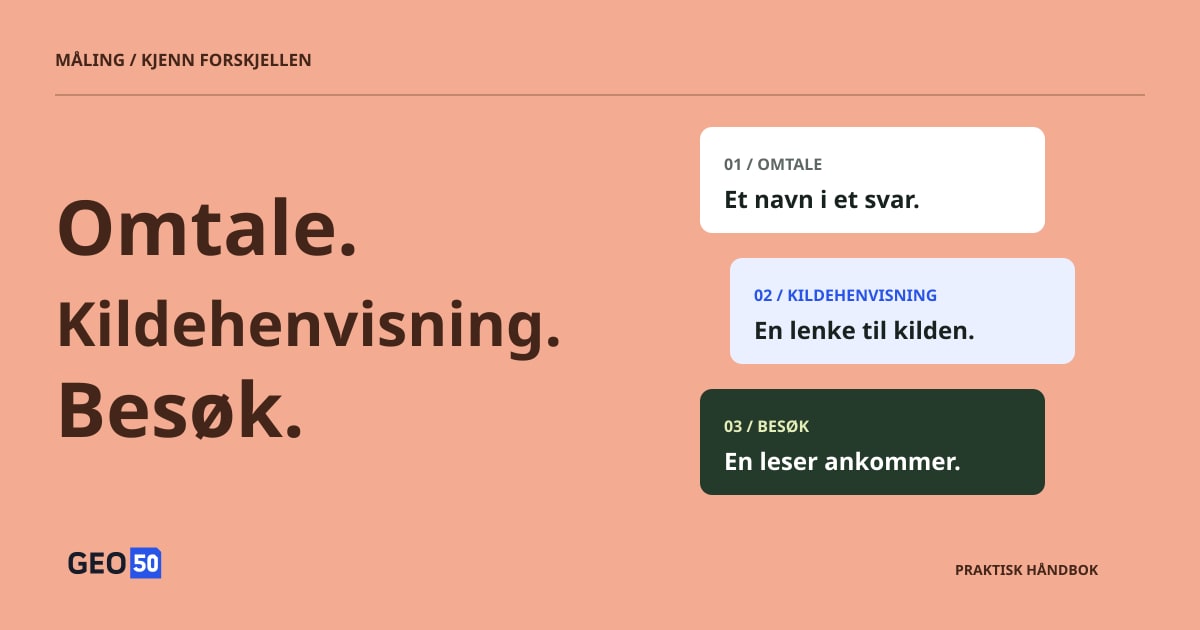
Tolk en GEO-poengsum ved å kontrollere hendelsen den teller, spørsmålene og prøvene bak den, og hvor mye svarene varierer. Omtaler, anbefalinger, kildehenvisninger og besøk beskriver forskjellige utfall. GEO50 kombinerer bekreftede merkevaresignaler til en rangering for en definert observasjon; å tolke en endring krever også sammenlignbare forhold og den underliggende dokumentasjonen.
Viktige poenger
- Identifiser hendelsen og nevneren før du sammenligner poengsummer.
- Bruk gjentatte svar og kildekontroller til å vurdere påliteligheten.
- Behandle rangeringen som dokumentasjon for en beslutning, ikke som et mål på produktkvalitet eller en bevist effekt av en redigering.
Begynn med beslutningen poengsummen skal støtte
En merkevares poengsum stiger etter en oppdatering av nettstedet. Det er fristende å kalle oppdateringen vellykket med en gang. Før du gjør det, spør hva som endret seg i de underliggende svarene: Ble merkevaren omtalt oftere, fikk den sterkere anbefalinger, eller fikk den lenker til nettstedet sitt? Dette er forskjellige forbedringer.
En nyttig måling begynner med et spørsmål som «Anbefaler relevante KI-svar produktet vårt for dette kundebehovet?». Spørsmålet bestemmer hvilke ledetekster som skal brukes til innsamling, hvilken hendelse som skal telles, og hvilken sammenligning som betyr noe. Den kritiske oversikten fra 2026 sier det tydelig: Definer ønsket utfall, nevner og en meningsfull forskjell før datainnsamlingen.
Skill tilstedeværelse fra preferanse og kildehenvisning
Et svar som sier «Acme er ett av flere planleggingsverktøy», gir en omtale. «Acme er et passende valg for dette byrået» legger til en anbefaling. «Acme er mitt førstevalg for disse behovene» uttrykker en sterkere preferanse. En kildelenke er en egen hendelse og kan peke til selskapet, en uavhengig omtale eller en konkurrent.
| Hendelse | Hva dokumentasjonen må vise |
|---|---|
| Omtale | Merkevaren er navngitt i svaret |
| Anbefaling | Svaret foreslår merkevaren som et passende valg |
| Førstevalg | Svaret identifiserer den uttrykkelig som det beste valget |
| Kildehenvisning til nettstedet | En lenke peker til selskapets egen side |
Dette skillet forklarer også hvorfor forskningsresultater ikke kan sammenlignes ut fra overskriften alene. C-SEO Bench evaluerer endringer i rekkefølgen på kildehenvisninger; det utfallet er noe annet enn hvor ofte en merkevare navngis eller uttrykkelig anbefales. I en automatisk rapport bør du gjennomgå et utvalg av originalsvarene for å kontrollere at merkelappene samsvarer med språket. Et merkenavn i en URL eller et produkt øverst i en liste er ikke tilstrekkelig dokumentasjon på en uttrykkelig førstevalgsanbefaling.
Kontroller hva en kildehenvisning faktisk støtter
En lenke gjør et svar mulig å undersøke, men beviser ikke at siden det lenkes til, støtter påstanden. I sin studie av generative søkemotorer fra 2023 undersøkte Liu, Zhang og Liang Bing Chat, NeevaAI, Perplexity og YouChat. På tvers av systemene de evaluerte, var 51.5% av de genererte utsagnene fullt støttet av kildehenvisninger, mens 74.5% av kildehenvisningene støttet utsagnene de var knyttet til. Dette er historiske kontrollresultater, ikke anslag for dagens plattformnøyaktighet.
De to tallene besvarer ulike spørsmål. Dekningsgrad for kildehenvisninger handler om hvorvidt utsagn som trenger verifisering, har full kildestøtte. Presisjon for kildehenvisninger handler om hvorvidt henvisningene som er lagt ved, støtter det svaret sier. Begge krever at kildene undersøkes, ikke bare at lenker telles.
Anta at et svar sier at et produkt fungerer uten nettilgang og inkluderer gratis oppstartshjelp. En side som bekrefter frakoblet bruk, støtter bare en del av setningen. Kontroller den andre påstanden, det aktuelle abonnementet og datoen før du behandler svaret som korrekt. Selv full kildestøtte er en test av kildeforankring, ikke et bevis på at selve kilden er sann. For en bedrift er den praktiske kontrollen om funksjonene og betingelsene overlever gjenfortellingen.
Gjør nevneren synlig
Tenk deg at 20 innsamlingsforsøk gir 16 brukbare svar, hvorav fire viser til selskapets nettsted. Andelen kildehenvisninger blant brukbare svar er 4/16, eller 25%; vellykket innsamling er 16/20, eller 80%. Disse hypotetiske tallene beskriver to forskjellige forhold. Hvis du bare rapporterer «25% synlighet», skjuler du mislykkede innsamlingsforsøk og lar hendelsen være udefinert.
Et fullført svar uten omtale av en merkevare er også noe annet enn en mislykket forespørsel. Det første er et observert fravær; det andre er manglende dokumentasjon. Registrer dem hver for seg, og oppgi hvilke observasjoner som inngår i hvert måltall.
Valget av spørsmål betyr like mye. «Er Acme et godt planleggingsverktøy?» tester en respons på en navngitt merkevare. «Hvilke verktøy passer for et lite byrå?» tester oppdagelse innen en kategori. Å blande disse uten å skille dem kan endre poengsummen bare ved å endre spørsmålene. Genererte spørsmål utgjør et testsett; de måler ikke hvor ofte virkelige kunder stiller hvert spørsmål.
Forvent variasjon mellom svar
Don’t Measure Once, en forhåndspublisert artikkel fra 2026, undersøkte fire KI-søkemotorer ved hjelp av observasjoner over tid og gjentatte kjøringer. I kildeanalysen innenfor en periode på 24 timer varierte gjennomsnittlig Jaccard-overlapp fra omtrent 32% til 43% på tvers av de fire kampanjekategoriene. Jaccard-overlapp sammenligner de felles kildene med unionen av de to kildemengdene; det er ikke en merkevares omtaleandel eller sannsynligheten for at et svar er riktig.
Analysen brukte opptil ti gjentakelser per motor–ledetekst og utelot kjøringer uten uthentede kildehenvisninger fra denne kildesammenligningen. Innsamlingskonteksten var sveitsisk, og utvalgte sektorer og regler for merkevaregjenkjenning begrenser generaliserbarheten ytterligere. Det nyttige funnet er at et nytt svar kan avvike betydelig selv uten et langt tidsintervall eller en endring på nettstedet.
Dette peker mot tre separate kontroller: Gjenta nøyaktig samme spørsmål for å undersøke variasjon mellom kjøringer, bruk likeverdige formuleringer for å undersøke følsomhet for ordlyd, og gjenta et fast spørsmålssett over tid for å undersøke endring. Et resultat som holder gjennom alle tre, er mer informativt enn ett gunstig skjermbilde.
Slik gjør GEO50 merkevaresignaler om til en poengsum
GEO50 oppsummerer bekreftede merkevaresignaler i innsamlede KI-svar fra samtaler med én tur. Den nåværende formelen er vår poengpolicy, ikke en formel foreskrevet av artiklene vi viser til her. Kildehenvisninger til nettsteder, henvisningsbesøk og kvaliteten på kildehenvisningene inngår ikke i denne poengsummen.
| Signal | Bidrag |
|---|---|
| Merkevaren forekommer i svaret | 20 × omtaleandel |
| Merkevaren anbefales uttrykkelig | 50 × anbefalingsandel |
| Merkevaren er uttrykkelig et førstevalg | 30 × førstevalgsandel |
| Merkevaren frarådes uttrykkelig | −50 × frarådingsandel |
Bruk andeler fra 0 til 1, summer bidragene og avgrens resultatet til 0–100. Førstevalg er en delmengde av anbefaling og får ekstra vekt. Rekkefølgen i en liste, fet skrift eller gjentakelser alene fastslår ikke førstevalg, og flere produkter fra samme merkevare i ett svar gir ikke ekstra poeng.
For ti hypotetiske, likt vektede svar får en merkevare som omtales nøytralt i alle ti, 20 poeng. En merkevare som anbefales i tre, er fraværende i sju og aldri identifiseres som førstevalg, får 21 poeng: 20 × 0.3 + 50 × 0.3. Forskjellen gjenspeiler poengpolicyens vekt på anbefaling; ingen av tallene er en kjøpssannsynlighet.
Gjentatte prøver gjennomsnittsberegnes innen hver kombinasjon av spørsmål og plattform, og kombinasjonene får lik vekt. Et fullstendig svar som ikke navngir noen merkevarer, forblir i nevneren. Alle planlagte prøver må være gyldige og analysert med en kompatibel metode før poengsummer og plasseringer vises. Ufullstendig innsamling gis ikke null poeng, og eksemplet med 4/16 kildehenvisninger tidligere i teksten kvalifiserer ikke en observasjon for en GEO50-rangering.
Tvetydige eller motstridende anbefalinger beholder en usikker vurdering i stedet for et antatt positivt eller negativt signal. Poengsummen oppsummerer dermed bekreftede signaler etter denne policyen. Den er ikke et konfidensnivå, et anslag for markedsandel eller en vurdering av produktkvalitet.

GEO50s nåværende poengpolicy, kontrollert mot implementasjonen. Førstevalg gir ekstra vekt til en anbefaling; tvetydige signaler forblir usikre. Dette er ikke en formel foreskrevet av de siterte artiklene. Se diagrammet i full størrelse.
Sammenlign observasjoner på samme grunnlag
En høyere poengsum blir informativ når sammenligningen bevarer målingens betydning. Oversiktens foreslåtte forskningsprotokoll kombinerer gjentatte målinger, omformuleringer, kontrollgrupper og menneskelig validering. Den bemerker også at svar er gruppert etter spørsmål, kilder og datoer: Å behandle hvert svar som en uavhengig kundepreferanse kan undervurdere usikkerheten. Martinez
I en bedriftsrapport bør du bevare en kortfattet sammenligningsoversikt:
| Dimensjon | Hold synlig |
|---|---|
| Spørsmål | Nøyaktig ordlyd, kundeintensjon og utvalgsmetode |
| Forhold | Plattform, produktgrensesnitt, språk, tiltenkt marked og tidspunkt |
| Prøver | Planlagte, brukbare og mislykkede observasjoner for hvert spørsmål og hver plattform |
| Endring | Sideversjoner, dato for tiltaket og en ubehandlet sammenligning der det er mulig |
| Dokumentasjon | Originalsvar, kilde-URL-er og kontroller av automatiske vurderinger |
Bruk en pilot til å vurdere variasjon og velge prøvedybde som passer beslutningen. Å øke antallet uten å forbedre spørsmålsdekningen eller konsistensen i innsamlingen kan fortsatt gi et misvisende resultat. GEO50s nåværende rangering viser ikke statistiske konfidensintervaller og fastslår ikke årsakseffekten av en redigering.
Bruk rangeringen til å velge hva som bør undersøkes
Et svakt resultat for et relevant kundebehov kan rette oppmerksomheten mot manglende produktopplysninger, uklar posisjonering eller sterkere svar fra konkurrenter. Et sterkere resultat kan avdekke en forklaring det er verdt å vedlikeholde. Gå gjennom de faktiske svarene før du bestemmer neste handling, og vurder spørsmålssettet og poengmetoden når du sammenligner observasjoner.
Hold forretningskonteksten atskilt fra det som er teknisk verifisert. Valg av et marked uttrykker den tiltenkte kjøpskonteksten; det gjenskaper ikke i seg selv en lokal brukers miljø. Trafikk fra Googles KI-funksjoner inngår i den samlede nettrapporteringen i Search Console, så totalen er ikke en separat telling av KI-kildehenvisninger. Nettstedsanalyse og kundehenvendelser gir ytterligere dokumentasjon på forretningsutfall. Google Search Central
GEO50 viser observasjonens omfang og hvor fullstendig innsamlingen er, og den nåværende nedlastingen inneholder den ferdige rangeringen, ikke hele svararkivet. Bruk den til å finne mønstre som er verdt å undersøke, og følg deretter dokumentasjonen inn i svarene og kundeopplevelsen. Vår veiledning for klargjøring av nettstedet forklarer hvordan et funn kan bli en definert innholdsforbedring.
Kilder og redaksjonell merknad
- Google Search Central — KI-funksjoner og nettstedet ditt ↗
Offisiell veiledning for Google AI Overviews og AI Mode; kontrollert 18. oktober 2026. Plattformkrav, ikke en eksperimentell studie.
- Schulte, Bleeker og Kaufmann — Ikke mål bare én gang: Måling av synlighet i KI-søk (GEO) ↗
Forhåndspublisert artikkel fra 2026, arXiv v1, 8. april. Del 3–6: kilde- og merkevareoverlapp over tid og ved gjentatte kjøringer på tvers av fire motorer. Sveitsisk innsamlingskontekst, utvalgte kampanjebransjer, delstrengbasert merkevaregjenkjenning og filtrering begrenser generaliserbarheten.
- Liu, Zhang og Liang — Evaluering av etterprøvbarhet i generative søkemotorer ↗
Findings of EMNLP 2023; arXiv v2, 23. oktober 2023. Del 2.3–2.4 og 4.2, samt begrensninger: dekningsgrad og presisjon for kildehenvisninger, og forskjellen mellom kildestøtte og faktisk sannhet. Historisk gjennomgang, ikke en aktuell plattformvurdering.
- Martinez — Optimalisering av synlighet i generative søkemotorer: En kritisk oversikt over optimalisering for generative søkemotorer (2023–2026) ↗
Forhåndspublisert oversiktsartikkel fra 2026, arXiv v1, 15. juli. Sammenstilling av 45 studier; del 3, 6 og 11 skiller mellom prosesstrinn, synlighetsutfall og måledesign. Brukes som forskningssammenstilling, ikke som uavhengig eksperimentell bekreftelse.
- Puerto mfl. — C-SEO Bench: Virker samtalebasert SEO? ↗
NeurIPS 2025, Datasets and Benchmarks Track. Del 4 og 6–7: to oppgaver, seks domener, rangering av kildehenvisninger og konkurrerende brukere av metodene. Engelskspråklig referansetest; eksperimenter med rekkefølge i konteksten viser ikke hvordan denne rekkefølgen kan oppnås i en søkemotor i drift.