GEO-scorer forklaret: Hvad tallet kan fortælle dig
Forstå, hvad en synlighedsscore tæller, hvor stabil den er, og hvordan forskning hjælper med at skelne en observeret rangering fra en pålidelig forretningskonklusion.

Opdateret
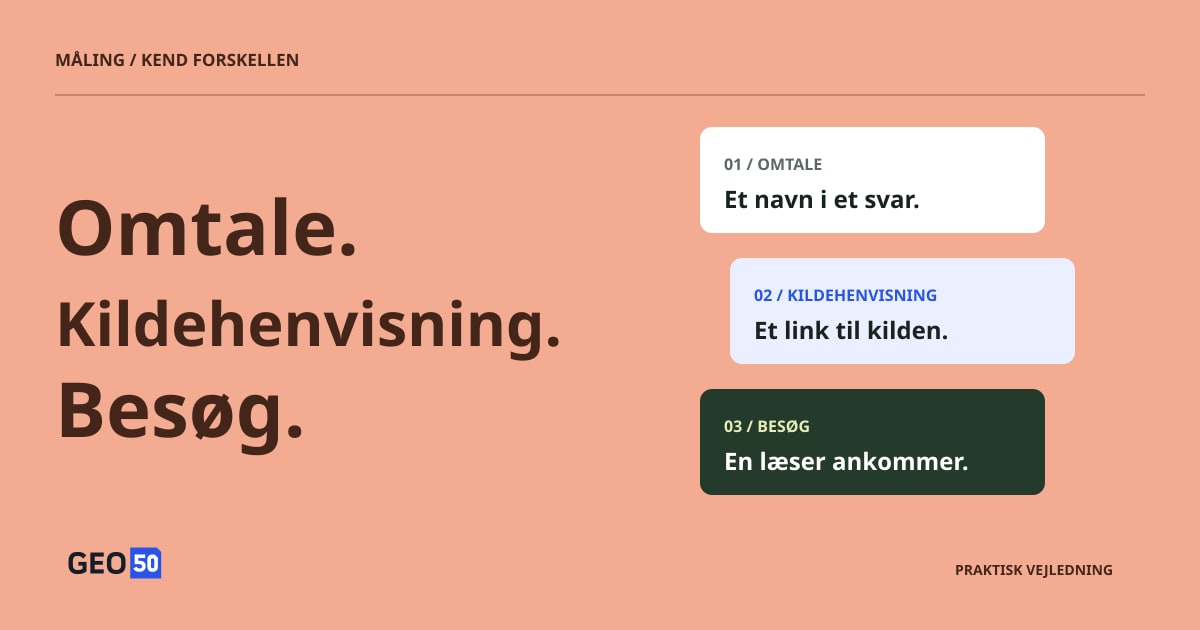
Læs en GEO-score ved at kontrollere den hændelse, den tæller, spørgsmålene og prøverne bag den, og hvor meget svarene varierer. Omtaler, anbefalinger, kildehenvisninger og besøg beskriver forskellige udfald. GEO50 kombinerer bekræftede brandsignaler til en rangering for en defineret observation; fortolkning af en ændring kræver også sammenlignelige forhold og den underliggende dokumentation.
Vigtige pointer
- Identificér hændelsen og nævneren, før du sammenligner scorer.
- Brug gentagne svar og kildekontrol til at vurdere pålidelighed.
- Behandl rangeringen som dokumentation til en beslutning, ikke som et mål for produktkvalitet eller en bevist effekt af en redigering.
Begynd med den beslutning, scoren skal understøtte
Et brands score stiger efter en websiteopdatering. Den umiddelbare fristelse er at kalde opdateringen vellykket. Spørg først, hvad der ændrede sig i de underliggende svar: Optrådte brandet oftere, fik det stærkere anbefalinger, eller fik det links til sit website? Det er forskellige forbedringer.
En nyttig måling begynder med et spørgsmål som »Anbefaler relevante AI-svar vores produkt til dette kundebehov?«. Spørgsmålet bestemmer, hvilke prompts der skal indsamles, hvilken hændelse der skal tælles, og hvilken sammenligning der har betydning. Den kritiske oversigt fra 2026 gør dette eksplicit: Definér det ønskede udfald, nævneren og en meningsfuld forskel, før data indsamles.
Adskil tilstedeværelse fra præference og kildehenvisning
Et svar, der siger »Acme er ét af flere planlægningsværktøjer«, dokumenterer en omtale. »Acme er et passende valg til dette bureau« tilføjer en anbefaling. »Acme er mit førstevalg til disse krav« udtrykker en stærkere præference. Et kildelink er en særskilt hændelse og kan pege på virksomheden, en uafhængig anmeldelse eller en konkurrent.
| Hændelse | Hvad dokumentationen skal vise |
|---|---|
| Omtale | Brandet nævnes ved navn i svaret |
| Anbefaling | Svaret foreslår brandet som et passende valg |
| Førstevalg | Svaret angiver det udtrykkeligt som det bedste valg |
| Kildehenvisning til websitet | Et link peger på virksomhedens egen side |
Dette skel forklarer også, hvorfor forskningsresultater ikke kan sammenlignes ud fra overskriften alene. C-SEO Bench evaluerer ændringer i kildehenvisningernes rækkefølge; det udfald er forskelligt fra, hvor ofte et brand navngives eller udtrykkeligt anbefales. Gennemgå i en automatiseret rapport et udvalg af originalsvarene for at kontrollere, at mærkaterne passer til sproget. Et brandnavn i en URL eller et produkt øverst på en liste er utilstrækkelig dokumentation for en udtrykkelig førstevalgsanbefaling.
Kontrollér, hvad en kildehenvisning faktisk understøtter
Et link gør et svar muligt at undersøge, men dokumenterer ikke, at den linkede side understøtter påstanden. I deres studie af generative søgemaskiner fra 2023 gennemgik Liu, Zhang og Liang Bing Chat, NeevaAI, Perplexity og YouChat. På tværs af de evaluerede systemer var 51.5% af de genererede udsagn fuldt understøttet af kildehenvisninger, mens 74.5% af kildehenvisningerne støttede deres tilknyttede udsagn. Det er historiske kontrolresultater, ikke estimater for nutidens platformnøjagtighed.
De to tal besvarer forskellige spørgsmål. Kildehenvisningers dækningsgrad handler om, hvorvidt udsagn, der kræver verifikation, har fuld kildestøtte. Kildehenvisningers præcision handler om, hvorvidt de vedlagte henvisninger understøtter det, svaret siger. Begge kræver undersøgelse af kilderne frem for optælling af links.
Antag, at et svar siger, at et produkt fungerer offline og omfatter gratis onboarding. En side, der bekræfter offlinebrug, understøtter kun en del af sætningen. Kontrollér den anden påstand, det relevante abonnement og datoen, før svaret behandles som korrekt. Selv fuld kildestøtte er en test af kildeforankring, ikke et bevis for, at selve kilden er sand. For en virksomhed er den praktiske kontrol, om funktioner og betingelser overlever genfortællingen.
Gør nævneren synlig
Forestil dig, at 20 indsamlingsforsøg giver 16 brugbare svar, hvoraf fire citerer virksomhedens website. Kildehenvisningsandelen blandt brugbare svar er 4/16 eller 25%; indsamlingssuccesen er 16/20 eller 80%. Disse hypotetiske tal beskriver to forskellige forhold. Kun at rapportere »25% synlighed« skjuler indsamlingsfejl og lader hændelsen være udefineret.
Et færdigt svar uden brandomtale er også forskelligt fra en mislykket anmodning. Det første er et observeret fravær; det andet er manglende dokumentation. Registrér dem adskilt, og angiv, hvilke observationer der indgår i hvert måltal.
Spørgsmålsvalget betyder lige så meget. »Er Acme et godt planlægningsværktøj?« tester et svar på et navngivet brand. »Hvilke værktøjer passer til et lille bureau?« tester opdagelse i en kategori. Hvis de blandes uden skelnen, kan scoren ændres alene ved at ændre spørgsmålene. Genererede spørgsmål udgør et testsæt; de måler ikke, hvor ofte virkelige kunder stiller hvert spørgsmål.
Forvent variation mellem svar
Mål ikke kun én gang, en forhåndsudgivet artikel fra 2026, undersøgte fire AI-søgemaskiner med observationer over tid og gentagne kørsler. I kildeanalysen inden for 24 timer varierede det gennemsnitlige Jaccard-overlap fra omkring 32% til 43% på tværs af de fire kampagnekategorier. Jaccard-overlap sammenligner fælles kilder med foreningen af de to kildemængder; det er ikke et brands omtaleandel eller sandsynligheden for, at et svar er korrekt.
Analysen brugte op til ti gentagelser pr. motor–prompt og udelukkede kørsler uden udtrukne kildehenvisninger fra denne kildesammenligning. Indsamlingskonteksten var schweizisk, og udvalgte sektorer samt regler for brandgenkendelse begrænser generalisering yderligere. Det nyttige fund er, at et andet svar kan afvige væsentligt, selv uden et langt tidsinterval eller en websiteredigering.
Det peger på tre særskilte kontroller: Gentag præcis samme spørgsmål for at undersøge variation mellem kørsler, brug tilsvarende formuleringer for at undersøge følsomhed for ordlyd, og gentag et fast spørgsmålssæt over tid for at undersøge forandring. Et resultat, der holder gennem alle tre, er mere informativt end ét fordelagtigt skærmbillede.
Sådan omsætter GEO50 brandsignaler til en score
GEO50 opsummerer bekræftede brandsignaler i indsamlede AI-svar fra samtaler med én tur. Den aktuelle formel er vores scoringspolitik, ikke en formel foreskrevet af de artikler, der citeres her. Websitehenvisninger, henvisningsbesøg og kildehenvisningers kvalitet ligger uden for denne score.
| Signal | Bidrag |
|---|---|
| Brandet optræder i svaret | 20 × omtaleandel |
| Brandet anbefales udtrykkeligt | 50 × anbefalingsandel |
| Brandet er udtrykkeligt et førstevalg | 30 × førstevalgsandel |
| Brandet frarådes udtrykkeligt | −50 × frarådningsandel |
Brug andele fra 0 til 1, læg bidragene sammen, og begræns resultatet til 0–100. Førstevalg er en delmængde af anbefaling og får ekstra vægt. Listerækkefølge, fed skrift eller gentagelser alene dokumenterer ikke førstevalg, og flere produkter fra samme brand i ét svar giver ikke ekstra point.
For ti hypotetiske, ligeligt vægtede svar scorer et brand, der omtales neutralt i alle ti, 20. Et brand, der anbefales i tre, er fraværende i syv og aldrig identificeres som førstevalg, scorer 21: 20 × 0.3 + 50 × 0.3. Forskellen afspejler scoringspolitikkens vægt på anbefaling; ingen af tallene er en købssandsynlighed.
Gentagne prøver gennemsnitsberegnes inden for hver spørgsmål–platform-kombination, og kombinationerne vægtes ens. Et fuldstændigt svar, der ikke nævner brands, bliver i nævneren. Alle planlagte prøver skal være gyldige og analyseret med en kompatibel metode, før scorer og placeringer vises. Ufuldstændig indsamling tildeles ikke nul, og det tidligere kildehenvisningseksempel med 4/16 kvalificerer ikke en observation til en GEO50-rangering.
Tvetydige eller modstridende anbefalinger beholder en usikker vurdering frem for et antaget positivt eller negativt signal. Scoren opsummerer derfor bekræftede signaler under denne politik. Den er ikke et konfidensniveau, et estimat af markedsandel eller en produktkvalitetsbedømmelse.

GEO50s aktuelle scoringspolitik, kontrolleret mod implementeringen. Førstevalg giver ekstra vægt til en anbefaling; tvetydige signaler forbliver usikre. Det er ikke en formel foreskrevet af de citerede artikler. Se diagrammet i fuld størrelse.
Sammenlign observationer på samme vilkår
En højere score bliver informativ, når sammenligningen bevarer målingens betydning. Oversigtens foreslåede forskningsprotokol kombinerer gentagne målinger, omformuleringer, kontrolgrupper og menneskelig validering. Den bemærker også, at svar er grupperet efter spørgsmål, kilder og datoer: At behandle hvert output som en uafhængig kundepræference kan undervurdere usikkerheden. Martinez
Bevar en kompakt sammenligningsoversigt i en virksomhedsrapport:
| Dimension | Hold synligt |
|---|---|
| Spørgsmål | Præcis ordlyd, kundeintention og udvælgelsesmetode |
| Forhold | Platform, produktgrænseflade, sprog, tiltænkt marked og tidspunkt |
| Prøver | Planlagte, brugbare og mislykkede observationer for hvert spørgsmål og hver platform |
| Ændring | Sideversioner, interventionsdato og en ubehandlet sammenligning, hvor muligt |
| Dokumentation | Originalsvar, kilde-URL'er og kontroller af automatiske vurderinger |
Brug en pilot til at vurdere variation og vælge stikprøvedybde til beslutningen. At øge antallet uden at forbedre spørgsmålsdækning eller indsamlingskonsistens kan stadig give et misvisende resultat. GEO50s aktuelle rangering viser ikke statistiske konfidensintervaller eller fastslår årsagseffekten af en redigering.
Brug rangeringen til at beslutte, hvad der skal undersøges
Et svagt resultat for et relevant kundebehov kan rette opmærksomheden mod manglende produktfakta, uklar positionering eller stærkere konkurrerende svar. Et stærkere resultat kan pege på en forklaring, der er værd at vedligeholde. Gennemgå de faktiske svar, før du vælger den næste handling, og sammenlign observationer med deres spørgsmålssæt og scoringsmetode for øje.
Hold forretningskonteksten adskilt fra det, der teknisk er verificeret. At vælge et marked udtrykker den tiltænkte købskontekst; det genskaber ikke i sig selv en lokal brugers miljø. Trafik fra Googles AI-funktioner indgår i den samlede webrapportering i Search Console, så totalen er ikke en selvstændig optælling af AI-kildehenvisninger. Websiteanalyse og kundehenvendelser tilfører yderligere dokumentation om forretningsudfald. Google Search Central
GEO50 viser observationens omfang og indsamlingens fuldstændighed, og den aktuelle download indeholder den færdige rangering frem for hele svararkivet. Brug den til at finde mønstre, der er værd at undersøge, og følg derefter dokumentationen ind i svarene og kundeoplevelsen. Vores vejledning til klargøring af websitet forklarer, hvordan et fund kan omsættes til en defineret indholdsforbedring.
Kilder og redaktionel note
- Google Search Central — AI-funktioner og dit website ↗
Officiel vejledning til Google AI Overviews og AI Mode; kontrolleret 18. oktober 2026. Platformskrav, ikke en eksperimentel undersøgelse.
- Schulte, Bleeker og Kaufmann — Mål ikke kun én gang: Måling af synlighed i AI-søgning (GEO) ↗
Forhåndsudgivet artikel fra 2026, arXiv v1, 8. april. Afsnit 3–6: kilde- og brandoverlap over tid og ved gentagne kørsler på tværs af fire motorer. Schweizisk indsamlingskontekst, udvalgte kampagnebrancher, delstrengbaseret brandgenkendelse og filtrering begrænser generalisering.
- Liu, Zhang og Liang — Evaluering af efterprøvbarhed i generative søgemaskiner ↗
Findings of EMNLP 2023; arXiv v2, 23. oktober 2023. Afsnit 2.3–2.4 og 4.2 samt begrænsninger: kildehenvisningers dækningsgrad, præcision og forskellen mellem kildestøtte og faktisk sandhed. Historisk gennemgang, ikke en aktuel bedømmelse af platforme.
- Martinez — Optimering af synlighed i generative søgemaskiner: En kritisk oversigt over optimering til generative søgemaskiner (2023–2026) ↗
Forhåndsudgivet oversigtsartikel fra 2026, arXiv v1, 15. juli. Sammenstilling af 45 studier; afsnit 3, 6 og 11 skelner mellem procestrin, synlighedsudfald og måledesign. Bruges som forskningssammenstilling, ikke som uafhængig eksperimentel bekræftelse.
- Puerto m.fl. — C-SEO Bench: Virker samtalebaseret SEO? ↗
NeurIPS 2025, Datasets and Benchmarks Track. Afsnit 4 og 6–7: to opgaver, seks domæner, rangering af kildehenvisninger og konkurrerende brugere af metoderne. Engelsksproget benchmark; eksperimenter med kontekstrækkefølge viser ikke en måde at opnå denne rækkefølge på i en søgemaskine i drift.