Punteggi GEO spiegati: cosa può dire il numero
Comprendi cosa conta un punteggio di visibilità, quanto è stabile e come la ricerca distingue una classifica osservata da una conclusione aziendale affidabile.

Aggiornato
Leggi un punteggio GEO controllando evento, domande, campioni e variazione delle risposte. Menzioni, raccomandazioni, citazioni e visite sono esiti distinti. GEO50 combina segnali confermati in una classifica per un’osservazione definita; interpretare un cambiamento richiede condizioni comparabili e prove sottostanti.
Punti chiave
- Identifica evento e denominatore prima di confrontare punteggi.
- Usa risposte ripetute e controlli delle fonti per valutarne l’affidabilità.
- Considera la classifica una prova per decidere, non qualità del prodotto o effetto dimostrato dell’editing.
Parti dalla decisione che il punteggio deve sostenere
Il punteggio di un marchio sale dopo un aggiornamento del sito. La tentazione è dichiarare riuscita la modifica. Prima, chiedi cosa è cambiato nelle risposte: più presenze, raccomandazioni più forti o link al sito? Sono miglioramenti differenti.
Una misurazione utile parte da “Le risposte IA pertinenti raccomandano il nostro prodotto per questo bisogno?”. La domanda determina prompt, evento contato e confronto significativo. La rassegna critica del 2026 lo esplicita: definire esito desiderato, denominatore e differenza significativa prima della raccolta.
Separa presenza, preferenza e citazione
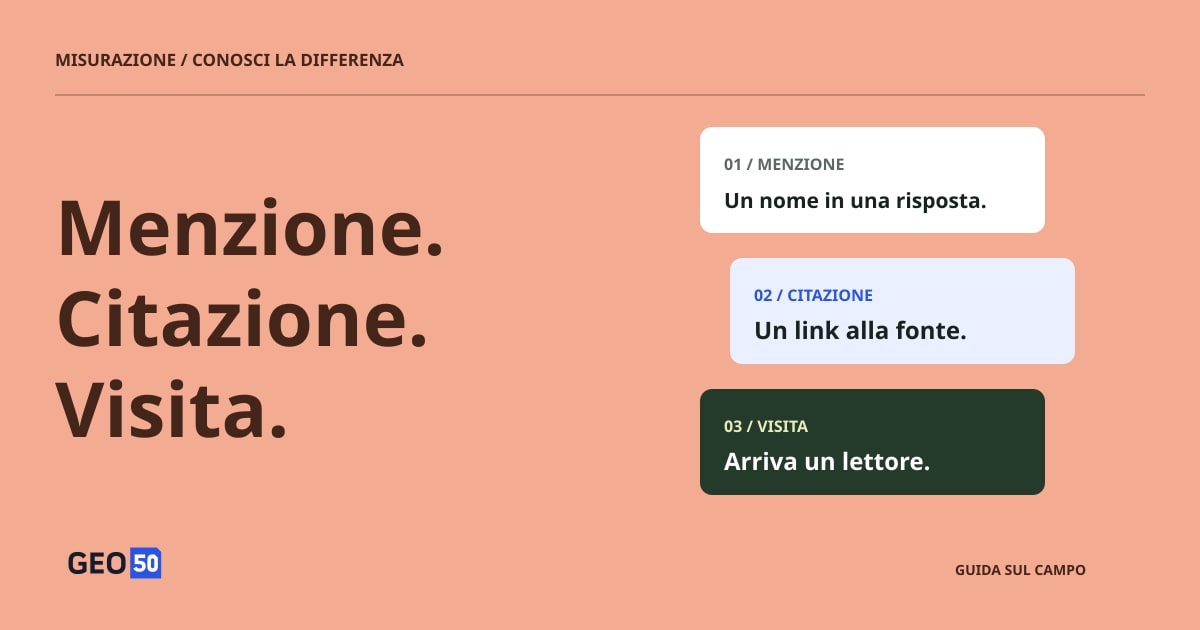
“Acme è uno dei vari strumenti di prenotazione” stabilisce una menzione. “Acme è adatto a questa agenzia” aggiunge una raccomandazione. “Acme è la mia prima scelta per questi requisiti” esprime una preferenza più forte. Un link a una fonte è un evento distinto e può puntare all’azienda, a una recensione indipendente o a un concorrente.
| Evento | Cosa devono mostrare le prove |
|---|---|
| Menzione | Il marchio è nominato nella risposta |
| Raccomandazione | La risposta propone il marchio come scelta adatta |
| Prima scelta | La risposta lo identifica esplicitamente come scelta migliore |
| Citazione del sito | Un link punta alla pagina dell’azienda |
Questo spiega perché non bastano i titoli per confrontare studi. C-SEO Bench valuta cambiamenti nell’ordine delle citazioni, non quanto spesso un marchio è nominato o consigliato esplicitamente. In un rapporto automatico controlla un campione di risposte originali per verificare che le etichette corrispondano al linguaggio. Un nome in un URL o un prodotto primo in elenco non prova una raccomandazione esplicita come prima scelta.
Controlla cosa sostiene davvero una citazione
Un link rende esaminabile una risposta, ma non dimostra che la pagina sostenga l’affermazione. Nello studio del 2023 sui motori generativi, Liu, Zhang e Liang hanno esaminato Bing Chat, NeevaAI, Perplexity e YouChat. Nei sistemi valutati, il 51.5% delle affermazioni era pienamente supportato da citazioni, mentre il 74.5% delle citazioni sosteneva le affermazioni associate. Sono risultati storici, non stime dell’accuratezza attuale.
Le cifre rispondono a domande diverse. La copertura delle citazioni riguarda il supporto completo alle affermazioni da verificare. La precisione riguarda se le citazioni allegate sostengono ciò che la risposta dice. Entrambe richiedono di esaminare fonti, non contare link.
Supponi che una risposta affermi funzionamento offline e avviamento gratuito. Una pagina che conferma l’offline sostiene solo parte della frase. Verifica l’altra affermazione, il piano applicabile e la data prima di considerarla accurata. Anche il supporto completo verifica l’attribuzione, non la verità della fonte. Per l’azienda conta controllare se capacità e condizioni sopravvivono alla riformulazione.
Rendi visibile il denominatore
Immagina 20 tentativi di raccolta con 16 risposte utilizzabili, quattro delle quali citano il sito. Il tasso di citazione tra risposte utilizzabili è 4/16, cioè 25%; il successo di raccolta è 16/20, cioè 80%. Sono cifre ipotetiche su due aspetti diversi. Dire soltanto “25% di visibilità” nasconde fallimenti e lascia l’evento indefinito.
Una risposta completa senza menzione differisce da una richiesta fallita. La prima è assenza osservata; la seconda è evidenza mancante. Registrale separatamente e dichiara quali osservazioni entrano nelle metriche.
Conta anche la scelta delle domande. “Acme è un buon strumento di prenotazione?” testa una risposta a un marchio nominato. “Quali strumenti sono adatti a una piccola agenzia?” testa la scoperta in categoria. Mescolarle senza distinzione può cambiare il punteggio solo cambiando domande. Quelle generate costituiscono un set di test, non misurano la frequenza reale delle domande dei clienti.
Aspettati variazioni tra risposte
Don’t Measure Once, preprint del 2026, ha esaminato quattro motori IA con osservazioni nel tempo e ripetizioni. Nell’analisi delle fonti entro 24 ore, la sovrapposizione media di Jaccard andava da circa 32% a 43% nelle quattro categorie di campagne. Jaccard confronta le fonti comuni con l’unione dei due insiemi; non è tasso di menzione né probabilità che una risposta sia corretta.
L’analisi usava fino a dieci ripetizioni per motore–prompt ed escludeva dal confronto delle fonti esecuzioni senza citazioni estratte. Contesto svizzero, settori selezionati e regole di rilevamento dei marchi limitano la generalizzazione. Il risultato utile è che una seconda risposta può differire molto senza lungo intervallo né modifica del sito.
Servono quindi tre verifiche: ripetere la stessa domanda per la variabilità tra esecuzioni, usare formulazioni equivalenti per la sensibilità al testo e ripetere un set fisso nel tempo per i cambiamenti. Un risultato che supera tutte e tre informa più di una schermata favorevole.
Come GEO50 traduce segnali di marchio in punteggio
GEO50 riassume segnali confermati in risposte IA campionate a turno singolo. La formula attuale è la nostra politica di valutazione, non una formula prescritta dagli articoli citati. Citazioni web, visite da referral e qualità delle citazioni sono fuori dal punteggio.
| Segnale | Contributo |
|---|---|
| Il marchio appare nella risposta | 20 × tasso di menzione |
| Il marchio è consigliato esplicitamente | 50 × tasso di raccomandazione |
| Il marchio è esplicitamente la prima scelta | 30 × tasso di prima scelta |
| Il marchio è sconsigliato esplicitamente | −50 × tasso di non raccomandazione |
Usa tassi da 0 a 1, somma i contributi e limita a 0–100. La prima scelta è un sottoinsieme della raccomandazione e riceve peso extra. Ordine, grassetto o ripetizione da soli non stabiliscono la prima scelta; più prodotti dello stesso marchio in una risposta non danno punti aggiuntivi.
Con dieci risposte ipotetiche di uguale peso, un marchio menzionato neutralmente in tutte ottiene 20. Un marchio consigliato in tre, assente in sette e mai prima scelta ottiene 21: 20 × 0.3 + 50 × 0.3. La differenza riflette l’enfasi sulla raccomandazione; nessuna cifra è probabilità di acquisto.
I campioni ripetuti sono mediati per combinazione domanda–piattaforma, e le combinazioni hanno peso uguale. Una risposta completa senza marchi rimane nel denominatore. Tutti i campioni previsti devono essere validi e analizzati con un metodo compatibile prima di mostrare punteggi e posizioni. Una raccolta incompleta non vale zero, e l’esempio di citazioni 4/16 non qualifica un’osservazione per la classifica GEO50.
Raccomandazioni ambigue o contraddittorie mantengono un giudizio incerto anziché un segnale presunto positivo o negativo. Il punteggio riassume quindi segnali confermati secondo la politica. Non è livello di fiducia, quota di mercato stimata o qualità del prodotto.

Politica attuale GEO50 verificata rispetto all’implementazione. La prima scelta aggiunge peso alla raccomandazione; i segnali ambigui restano incerti. La formula non è prescritta dagli studi citati. Visualizza il diagramma a dimensione intera.
Confronta osservazioni alle stesse condizioni
Un punteggio maggiore informa quando il confronto conserva il significato della misura. Il protocollo proposto dalla rassegna combina ripetizioni, parafrasi, controlli e validazione umana. Nota inoltre che risposte sono raggruppate per domande, fonti e date: trattare ogni output come preferenza indipendente può sottostimare l’incertezza. Martinez
Per un rapporto aziendale, conserva un registro compatto:
| Dimensione | Cosa rendere visibile |
|---|---|
| Domande | Testo esatto, intento del cliente e selezione |
| Condizioni | Piattaforma, interfaccia del prodotto, lingua, mercato e momento |
| Campioni | Osservazioni previste, utilizzabili e fallite per domanda e piattaforma |
| Cambiamento | Versioni delle pagine, data dell’intervento e confronto non trattato se fattibile |
| Prove | Risposte originali, URL delle fonti e controlli dei giudizi automatici |
Usa un pilota per valutare variabilità e profondità di campionamento. Aumentare quantità senza migliorare copertura delle domande o coerenza della raccolta può comunque ingannare. La classifica attuale di GEO50 non mostra intervalli statistici di confidenza né dimostra l’effetto causale dell’editing.
Usa la classifica per scegliere cosa approfondire
Un risultato debole per un bisogno rilevante può indicare fatti mancanti, posizionamento poco chiaro o risposte concorrenti più forti. Uno migliore può identificare una spiegazione da mantenere. Esamina le risposte reali prima di agire e confronta con domande e metodo di valutazione in vista.
Separa contesto commerciale e verifica tecnica. Scegliere un mercato indica il contesto d’acquisto previsto, non riproduce l’ambiente di un utente locale. Il traffico delle funzioni IA di Google è incluso nei report Web complessivi di Search Console, quindi non è un conteggio separato di citazioni IA. Analisi del sito e richieste clienti aggiungono prove degli esiti commerciali. Google Search Central
GEO50 mostra ambito e completezza della raccolta; il download attuale include la classifica completa, non l’intero archivio delle risposte. Usalo per trovare schemi da esaminare, poi segui le prove nelle risposte e nell’esperienza cliente. La guida alla preparazione del sito spiega come trasformare un risultato in un miglioramento definito.
Fonti e nota editoriale
- Google Search Central — Funzioni IA e il tuo sito ↗
Indicazioni ufficiali per Google AI Overviews e AI Mode; verificate il 18 ottobre 2026. Requisiti di piattaforma, non studio sperimentale.
- Schulte, Bleeker e Kaufmann — Non misurare una volta sola: misurare la visibilità nella ricerca IA (GEO) ↗
Preprint del 2026, arXiv v1, 8 aprile. Sezioni 3–6: sovrapposizione longitudinale e ripetuta di fonti/marchi in quattro motori. Contesto svizzero, settori selezionati, rilevamento tramite sottostringhe e filtraggio limitano la generalizzazione.
- Liu, Zhang e Liang — Valutare la verificabilità nei motori di ricerca generativi ↗
Findings of EMNLP 2023; arXiv v2, 23 ottobre 2023. Sezioni 2.3–2.4 e 4.2 e Limiti: copertura e precisione delle citazioni e differenza tra supporto delle fonti e verità fattuale. Audit storico, non valutazione attuale delle piattaforme.
- Martinez — Ottimizzare la visibilità nei motori generativi: rassegna critica di GEO (2023–2026) ↗
Preprint di rassegna del 2026, arXiv v1, 15 luglio. Sintesi di 45 studi; sezioni 3, 6 e 11 distinguono fasi, esiti di visibilità e disegno delle misure. Usare come sintesi, non conferma sperimentale indipendente.
- Puerto et al. — C-SEO Bench: la SEO conversazionale funziona? ↗
NeurIPS 2025, sezione Datasets and Benchmarks. Sezioni 4 e 6–7: due compiti, sei domini, ordine delle citazioni e adozione concorrente. Benchmark in inglese; gli esperimenti sull’ordine del contesto non mostrano come ottenerlo su un motore reale.