Przeczytaj angielski oryginał ↗
Wyniki GEO: co może powiedzieć Ci liczba
Zrozum, co zlicza wynik widoczności, jak jest stabilny i jak badania pomagają odróżnić zaobserwowany ranking od rzetelnego wniosku biznesowego.

Zaktualizowano
Czytaj wynik GEO, sprawdzając zliczane zdarzenie, stojące za nim pytania i próbki oraz zmienność odpowiedzi. Wzmianki, rekomendacje, cytowania i wizyty opisują różne rezultaty. GEO50 łączy potwierdzone sygnały marek w ranking dla określonej obserwacji; interpretacja zmiany wymaga też porównywalnych warunków i dowodów źródłowych.
Najważniejsze wnioski
- Przed porównywaniem wyników określ zdarzenie i mianownik.
- Oceń rzetelność przez powtarzanie odpowiedzi i sprawdzanie źródeł.
- Traktuj ranking jako dowód wspierający decyzję, a nie miarę jakości produktu lub udowodniony efekt edycji.
Zacznij od decyzji, którą wynik ma wspierać
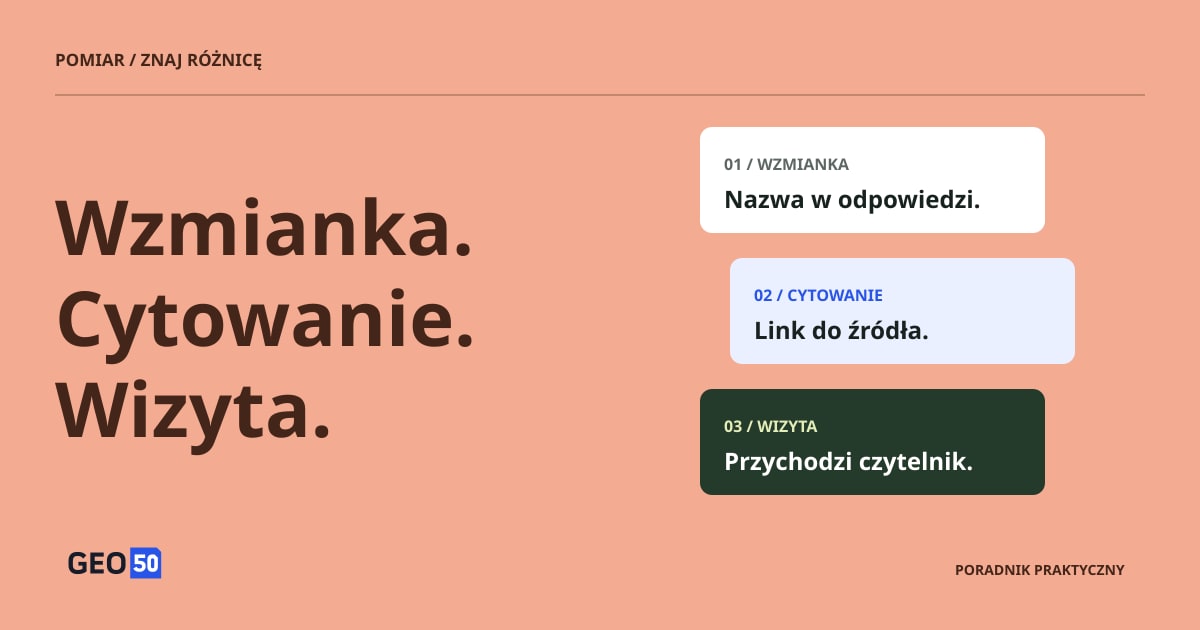
Wynik marki rośnie po aktualizacji witryny. Pierwszą pokusą jest ogłoszenie sukcesu aktualizacji. Zanim to zrobisz, zapytaj, co zmieniło się w odpowiedziach: czy marka pojawiała się częściej, otrzymywała mocniejsze rekomendacje, czy zyskała linki do swojej witryny? To różne ulepszenia.
Użyteczny pomiar zaczyna się od pytania takiego jak „Czy istotne odpowiedzi AI rekomendują nasz produkt dla tej potrzeby klienta?”. Pytanie określa, jakie zapytania zbierać, jakie zdarzenie liczyć i jakie porównanie będzie istotne. Krytyczny przegląd z 2026 roku mówi o tym wprost: przed zbieraniem danych określ oczekiwany rezultat, mianownik i znaczącą różnicę.
Oddziel obecność od preferencji i cytowania
Odpowiedź „Acme jest jednym z kilku narzędzi do planowania terminów” potwierdza wzmiankę. „Acme jest odpowiednim wyborem dla tej agencji” dodaje rekomendację. „Acme jest moim pierwszym wyborem przy tych wymaganiach” wyraża silniejszą preferencję. Link źródłowy jest odrębnym zdarzeniem i może prowadzić do firmy, niezależnej recenzji lub konkurenta.
| Zdarzenie | Co muszą wykazać dowody |
|---|---|
| Wzmianka | Marka jest wymieniona w odpowiedzi |
| Rekomendacja | Odpowiedź proponuje markę jako odpowiedni wybór |
| Pierwszy wybór | Odpowiedź wyraźnie wskazuje markę jako najlepszy wybór |
| Cytowanie witryny | Link prowadzi do własnej strony firmy |
To rozróżnienie wyjaśnia też, dlaczego wyników badań nie można porównywać na podstawie samego nagłówka. C-SEO Bench ocenia zmiany kolejności cytowań; to inny rezultat niż częstotliwość wymieniania lub wyraźnego rekomendowania marki. W automatycznym raporcie przejrzyj próbkę oryginalnych odpowiedzi, aby sprawdzić, czy etykiety odpowiadają językowi. Nazwa marki w URL lub produkt na początku listy nie wystarczają jako dowód wyraźnej rekomendacji pierwszego wyboru.
Sprawdź, co cytowanie faktycznie potwierdza
Link umożliwia kontrolę odpowiedzi, ale nie dowodzi, że podlinkowana strona wspiera twierdzenie. W badaniu generatywnych wyszukiwarek z 2023 roku Liu, Zhang i Liang przeprowadzili audyt Bing Chat, NeevaAI, Perplexity i YouChat. W ocenianych systemach 51.5% wygenerowanych stwierdzeń było w pełni wspartych cytowaniami, a 74.5% cytowań wspierało przypisane im stwierdzenia. To historyczne wyniki audytu, a nie szacunki dzisiejszej trafności platform.
Te dwie wartości odpowiadają na różne pytania. Kompletność cytowań dotyczy tego, czy stwierdzenia wymagające weryfikacji mają pełne wsparcie źródłowe. Precyzja cytowań dotyczy tego, czy dołączone odwołania wspierają treść odpowiedzi. Obie wymagają zbadania źródeł, a nie liczenia linków.
Załóżmy, że odpowiedź mówi, iż produkt działa offline i obejmuje bezpłatne wdrożenie. Strona potwierdzająca użycie offline wspiera tylko część tego zdania. Zanim uznasz odpowiedź za poprawną, sprawdź drugie twierdzenie, właściwy plan i datę. Nawet pełne wsparcie źródłowe sprawdza przypisanie informacji, a nie dowodzi prawdziwości samego źródła. Dla firmy praktyczna kontrola polega na tym, czy możliwości i warunki zachowują sens w powtórnym opisie.
Pokaż mianownik
Wyobraźmy sobie, że 20 prób zbierania danych daje 16 użytecznych odpowiedzi, z których cztery cytują witrynę firmy. Odsetek cytowań wśród użytecznych odpowiedzi to 4/16, czyli 25%; skuteczność zbierania wynosi 16/20, czyli 80%. Te hipotetyczne wartości opisują dwie różne rzeczy. Podanie wyłącznie „25% widoczności” ukrywa nieudane próby i pozostawia zdarzenie niezdefiniowane.
Ukończona odpowiedź bez wzmianki o marce różni się też od nieudanego żądania. Pierwsza jest zaobserwowaną nieobecnością; drugie to brak dowodów. Zapisuj je osobno i podawaj, które obserwacje wchodzą do każdej miary.
Wybór pytań jest równie ważny. „Czy Acme jest dobrym narzędziem do planowania terminów?” bada reakcję na wskazaną markę. „Które narzędzia pasują do małej agencji?” bada odkrywanie w kategorii. Łączenie ich bez rozróżnienia może zmienić wynik tylko poprzez zmianę pytań. Wygenerowane pytania tworzą zestaw testowy; nie mierzą częstotliwości, z jaką prawdziwi klienci zadają każde pytanie.
Oczekuj zmienności między odpowiedziami
Nie mierz tylko raz, preprint z 2026 roku, analizuje cztery wyszukiwarki AI na podstawie obserwacji w czasie i powtarzanych prób. W analizie źródeł w ciągu 24 godzin średni współczynnik podobieństwa Jaccarda wynosił od około 32% do 43% w czterech kategoriach kampanii. Porównuje on wspólne źródła z sumą dwóch zbiorów źródeł; nie jest odsetkiem wzmianek o marce ani prawdopodobieństwem poprawności odpowiedzi.
Analiza stosowała do dziesięciu powtórzeń na parę silnik–zapytanie i wykluczała z porównania źródeł próby bez wyodrębnionych cytowań. Dane zbierano w kontekście szwajcarskim, a wybrane sektory i reguły wykrywania marek dodatkowo ograniczają uogólnianie. Użyteczny wniosek: druga odpowiedź może znacznie się różnić nawet bez długiego odstępu czasu lub edycji witryny.
Sugeruje to trzy odrębne kontrole: powtórz identyczne pytanie, by zbadać zmienność między próbami; użyj równoważnych sformułowań, by zbadać wrażliwość na brzmienie; i powtarzaj stały zestaw pytań w czasie, by zbadać zmianę. Rezultat utrzymujący się we wszystkich trzech kontrolach mówi więcej niż jeden korzystny zrzut ekranu.
Jak GEO50 zamienia sygnały marki w wynik
GEO50 podsumowuje potwierdzone sygnały marek w próbkowanych odpowiedziach AI z pojedynczej tury. Obecna formuła jest naszą polityką punktacji, a nie wzorem zaleconym przez cytowane tu publikacje. Cytowania witryny, wizyty z odesłań i jakość cytowań nie wchodzą do tego wyniku.
| Sygnał | Wkład |
|---|---|
| Marka pojawia się w odpowiedzi | 20 × odsetek wzmianek |
| Marka jest wyraźnie rekomendowana | 50 × odsetek rekomendacji |
| Marka jest wyraźnie pierwszym wyborem | 30 × odsetek pierwszego wyboru |
| Marka jest wyraźnie odradzana | −50 × odsetek odradzeń |
Stosuj odsetki od 0 do 1, dodaj wkłady i ogranicz wynik do 0–100. Pierwszy wybór jest podzbiorem rekomendacji i otrzymuje dodatkową wagę. Sama kolejność listy, pogrubienie lub powtórzenie nie dowodzą pierwszego wyboru, a kilka produktów tej samej marki w jednej odpowiedzi nie daje dodatkowych punktów.
Dla dziesięciu hipotetycznych odpowiedzi o równej wadze marka neutralnie wymieniona we wszystkich dziesięciu otrzymuje 20. Marka rekomendowana w trzech, nieobecna w siedmiu i nigdy niewskazana jako pierwszy wybór otrzymuje 21: 20 × 0.3 + 50 × 0.3. Różnica odzwierciedla nacisk polityki punktacji na rekomendacje; żadna liczba nie jest prawdopodobieństwem zakupu.
Powtarzane próbki są uśredniane w każdej kombinacji pytanie–platforma, a kombinacje mają równe wagi. Pełna odpowiedź niewymieniająca marek pozostaje w mianowniku. Wszystkie zaplanowane próbki muszą być prawidłowe i przeanalizowane zgodną metodą, zanim pokażemy wyniki i pozycje. Niepełnym zbiorom nie przypisuje się zera, a wcześniejszy przykład cytowań 4/16 nie kwalifikuje obserwacji do rankingu GEO50.
Niejednoznaczne lub sprzeczne rekomendacje zachowują ocenę niepewną zamiast założonego sygnału pozytywnego lub negatywnego. Wynik podsumowuje więc potwierdzone sygnały według tej polityki. Nie jest poziomem ufności, szacunkiem udziału w rynku ani oceną jakości produktu.

Obecna polityka punktacji GEO50, sprawdzona względem implementacji. Pierwszy wybór zwiększa wagę rekomendacji; niejednoznaczne sygnały pozostają niepewne. Nie jest to formuła zalecona przez cytowane publikacje. Zobacz schemat w pełnym rozmiarze.
Porównuj obserwacje na tych samych zasadach
Wyższy wynik staje się użyteczny, gdy porównanie zachowuje znaczenie pomiaru. Proponowany w przeglądzie protokół badawczy łączy powtarzane pomiary, parafrazy, kontrole i weryfikację przez człowieka. Wskazuje też, że odpowiedzi grupują się według pytań, źródeł i dat: traktowanie każdego wyniku jako niezależnej preferencji klienta może zaniżać niepewność. Martinez
W raporcie biznesowym zachowaj zwięzły zapis porównania:
| Wymiar | Co pokazać |
|---|---|
| Pytania | Dokładne brzmienie, intencję klienta i metodę doboru |
| Warunki | Platformę, interfejs produktu, język, docelowy rynek i czas |
| Próbki | Zaplanowane, użyteczne i nieudane obserwacje dla każdego pytania i platformy |
| Zmiana | Wersje strony, datę interwencji i niezmienione porównanie, gdy to możliwe |
| Dowody | Oryginalne odpowiedzi, URL źródeł i kontrole automatycznych ocen |
Użyj pilotażu, aby ocenić zmienność i dobrać głębokość próbkowania do decyzji. Zwiększenie liczby prób bez poprawy pokrycia pytań lub spójności zbierania danych nadal może dać mylący rezultat. Obecny ranking GEO50 nie pokazuje statystycznych przedziałów ufności ani nie ustala przyczynowego efektu edycji.
Wykorzystaj ranking, aby zdecydować, co zbadać
Słaby wynik dla istotnej potrzeby klienta może skierować uwagę na brakujące fakty o produkcie, niejasne pozycjonowanie lub mocniejsze odpowiedzi konkurencji. Lepszy wynik może wskazać wyjaśnienie warte utrzymania. Przed wyborem działania przejrzyj rzeczywiste odpowiedzi i porównuj obserwacje z uwzględnieniem zestawu pytań oraz metody punktacji.
Oddziel kontekst biznesowy od tego, co zweryfikowano technicznie. Wybór rynku wyraża docelowy kontekst zakupowy; sam w sobie nie odtwarza środowiska lokalnego użytkownika. Ruch z funkcji AI Google jest uwzględniony w ogólnym raporcie internetowym Search Console, więc suma ta nie jest odrębną liczbą cytowań AI. Analityka witryny i zapytania klientów dostarczają dalszych dowodów rezultatów biznesowych. Google Search Central
GEO50 pokazuje zakres obserwacji i kompletność zbierania danych, a obecny plik do pobrania zawiera ukończony ranking, nie pełne archiwum odpowiedzi. Użyj go do znalezienia wzorców wartych zbadania, a następnie podążaj za dowodami w odpowiedziach i doświadczeniu klienta. Nasz przewodnik przygotowania witryny wyjaśnia, jak przekuć ustalenie w określone ulepszenie treści.
Źródła i uwaga redakcyjna
- Google Search Central — Funkcje AI a Twoja witryna ↗
Oficjalne wytyczne dla Google AI Overviews i AI Mode; sprawdzono 18 października 2026. Wymogi platformy, nie badanie eksperymentalne.
- Schulte, Bleeker i Kaufmann — Nie mierz tylko raz: pomiar widoczności w wyszukiwaniu AI (GEO) ↗
Preprint z 2026 roku, arXiv v1, 8 kwietnia. Sekcje 3–6: pokrywanie się źródeł i marek w obserwacjach podłużnych oraz powtarzanych próbach w czterech silnikach. Szwajcarski kontekst zbierania danych, wybrane branże kampanii, wykrywanie marek na podstawie podciągów i filtrowanie ograniczają uogólnianie.
- Liu, Zhang i Liang — Ocena weryfikowalności w generatywnych wyszukiwarkach ↗
Findings of EMNLP 2023; arXiv v2, 23 października 2023. Sekcje 2.3–2.4 i 4.2 oraz Ograniczenia: kompletność cytowań, precyzja cytowań i różnica między wsparciem źródłowym a prawdą faktograficzną. Audyt historyczny, nie bieżąca ocena platform.
- Martinez — Optymalizacja widoczności w silnikach generatywnych: krytyczny przegląd optymalizacji pod kątem silników generatywnych (2023–2026) ↗
Preprint przeglądu z 2026 roku, arXiv v1, 15 lipca. Synteza 45 badań; sekcje 3, 6 i 11 rozróżniają etapy procesu, rezultaty widoczności i projektowanie pomiaru. Traktuj jako syntezę badań, a nie niezależne potwierdzenie eksperymentalne.
- Puerto i in. — C-SEO Bench: czy konwersacyjne SEO działa? ↗
NeurIPS 2025, ścieżka zbiorów danych i benchmarków. Sekcje 4 i 6–7: dwa zadania, sześć dziedzin, kolejność cytowań i konkurujący użytkownicy metod. Benchmark anglojęzyczny; eksperymenty z kolejnością kontekstu nie dowodzą sposobu uzyskania tej kolejności w działającym silniku.