Оценки GEO: о чём может рассказать число
Разберитесь, что считает оценка видимости, насколько она стабильна и как исследования помогают отличить наблюдаемый рейтинг от надёжного бизнес-вывода.

Обновлено
Чтобы читать оценку GEO, проверьте учитываемое событие, вопросы и выборки за ним, а также вариативность ответов. Упоминания, рекомендации, цитирования и посещения описывают разные результаты. GEO50 объединяет подтверждённые сигналы бренда в рейтинг для заданного наблюдения; трактовка изменения также требует сопоставимых условий и исходных доказательств.
Основные выводы
- Определите событие и знаменатель до сравнения оценок.
- Используйте повторные ответы и проверку источников для оценки надёжности.
- Рассматривайте рейтинг как свидетельство для решения, а не меру качества продукта или доказанный эффект правки.
Начните с решения, которому должна помогать оценка
После обновления сайта оценка бренда растёт. Первый соблазн — назвать обновление успешным. Прежде спросите, что изменилось в исходных ответах: бренд стал появляться чаще, получать более сильные рекомендации или ссылки на свой сайт? Это разные улучшения.
Полезное измерение начинается с вопроса вроде «Рекомендуют ли соответствующие ответы ИИ наш продукт для этой потребности клиента?». Он определяет, какие запросы собирать, какое событие считать и какое сравнение важно. Критический обзор 2026 года говорит об этом прямо: определите целевой результат, знаменатель и значимую разницу до сбора данных.
Отделяйте присутствие от предпочтения и цитирования
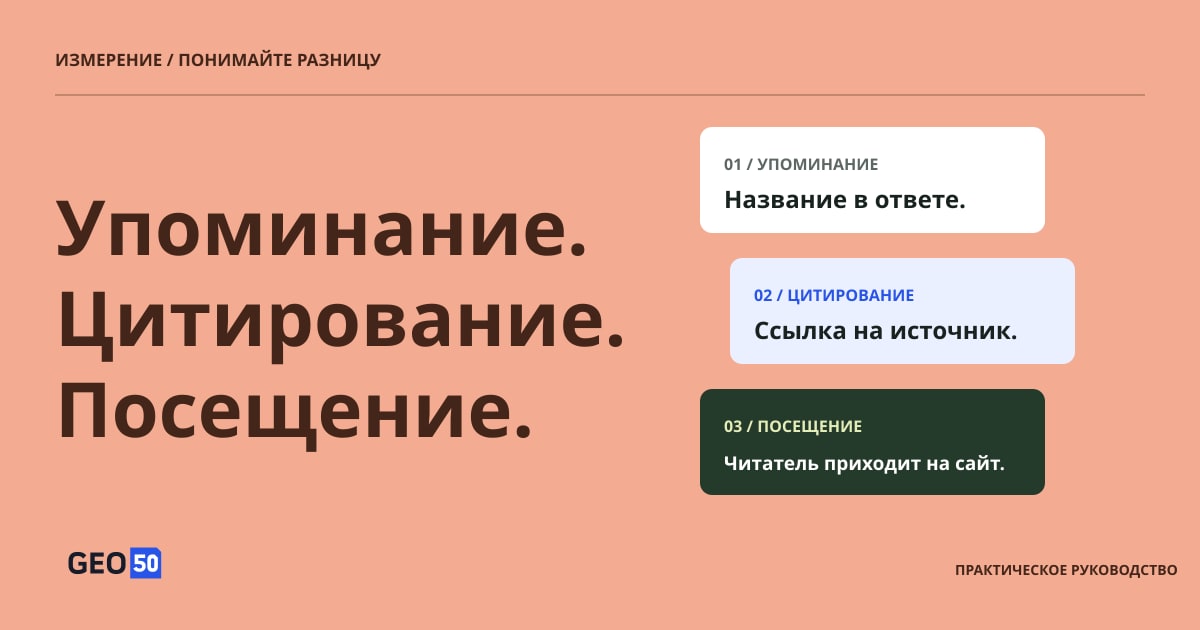
Ответ «Acme — один из нескольких инструментов планирования» означает упоминание. «Acme подходит этому агентству» добавляет рекомендацию. «Acme — мой первый выбор для этих требований» выражает более сильное предпочтение. Ссылка на источник — отдельное событие: она может вести на компанию, независимый обзор или конкурента.
| Событие | Что должны показывать доказательства |
|---|---|
| Упоминание | Бренд назван в ответе |
| Рекомендация | Ответ предлагает бренд как подходящий вариант |
| Первый выбор | Ответ явно называет его лучшим выбором |
| Цитирование сайта | Ссылка ведёт на собственную страницу компании |
Это различие объясняет, почему результаты исследований нельзя сравнивать только по заголовку. C-SEO Bench оценивает изменения порядка цитирования; это отличается от частоты называния или явной рекомендации бренда. В автоматическом отчёте просмотрите выборку оригинальных ответов и проверьте соответствие меток формулировкам. Название бренда в URL или первое место продукта в списке недостаточны для вывода о явной рекомендации в качестве первого выбора.
Проверяйте, что именно подтверждает цитирование
Ссылка делает ответ проверяемым, но не доказывает, что указанная страница подтверждает утверждение. В исследовании генеративных поисковых систем 2023 года Liu, Zhang и Liang проверили Bing Chat, NeevaAI, Perplexity и YouChat. В оценённых системах 51.5% сгенерированных утверждений были полностью подтверждены цитированиями, а 74.5% цитирований подтверждали связанные утверждения. Это результаты исторической проверки, а не оценки точности сегодняшних платформ.
Эти числа отвечают на разные вопросы. Полнота цитирования касается того, имеют ли требующие проверки утверждения полное подтверждение источниками. Точность цитирования — того, подтверждают ли приложенные ссылки сказанное в ответе. Для обоих показателей нужно изучать источники, а не просто считать ссылки.
Допустим, ответ говорит, что продукт работает офлайн и включает бесплатное внедрение. Страница, подтверждающая офлайн-работу, поддерживает лишь часть предложения. Прежде чем считать ответ точным, проверьте другое утверждение, применимый тариф и дату. Даже полное подтверждение источником — это проверка атрибуции, а не доказательство истинности самого источника. Для бизнеса практическая проверка состоит в том, сохраняются ли возможности и условия при пересказе.
Делайте знаменатель видимым
Представьте, что 20 попыток сбора дали 16 пригодных ответов, четыре из которых ссылаются на сайт компании. Частота цитирования среди пригодных ответов — 4/16, или 25%; успешность сбора — 16/20, или 80%. Эти гипотетические числа описывают разные вещи. Формулировка только «25% видимости» скрывает неудачи сбора и оставляет событие неопределённым.
Завершённый ответ без упоминания бренда также отличается от неудачного запроса. Первый — наблюдаемое отсутствие, второй — отсутствующее свидетельство. Фиксируйте их отдельно и указывайте, какие наблюдения входят в каждую метрику.
Выбор вопросов не менее важен. «Acme — хороший инструмент планирования?» проверяет реакцию на названный бренд. «Какие инструменты подходят небольшому агентству?» проверяет обнаружение в категории. Если смешивать их без различия, оценка может измениться просто из-за вопросов. Сгенерированные вопросы образуют тестовый набор; они не измеряют, как часто каждый вопрос задают реальные клиенты.
Ожидайте вариативности ответов
Препринт 2026 года Don’t Measure Once изучал четыре поисковые системы ИИ с наблюдениями во времени и повторными запусками. В анализе источников внутри 24 часов среднее пересечение Жаккара составляло примерно от 32% до 43% по четырём категориям кампаний. Пересечение Жаккара сравнивает общие источники с объединением двух наборов источников; это не частота упоминания бренда и не вероятность правильности ответа.
Анализ использовал до десяти повторов на пару «система–запрос» и исключал из сравнения источников запуски без извлечённых цитирований. Сбор проходил в швейцарском контексте, а выбранные отрасли и правила обнаружения брендов дополнительно ограничивают обобщение. Полезный вывод: второй ответ может заметно отличаться даже без большого временного интервала или изменения сайта.
Отсюда три отдельные проверки: повторяйте один и тот же вопрос для изучения вариативности запусков, используйте равнозначные формулировки для проверки чувствительности к словам и повторяйте фиксированный набор вопросов со временем для оценки изменений. Результат, выдерживающий все три проверки, информативнее одного удачного скриншота.
Как GEO50 превращает сигналы бренда в оценку
GEO50 обобщает подтверждённые сигналы брендов в выборке однократных ответов ИИ. Текущая формула — наша политика оценки, а не формула, предписанная цитируемыми здесь исследованиями. Цитирования сайта, переходы и качество цитирования в эту оценку не входят.
| Сигнал | Вклад |
|---|---|
| Бренд появляется в ответе | 20 × частота упоминаний |
| Бренд явно рекомендован | 50 × частота рекомендаций |
| Бренд явно назван первым выбором | 30 × частота первого выбора |
| Бренд явно не рекомендован | −50 × частота нерекомендаций |
Используйте частоты от 0 до 1, сложите вклады и ограничьте результат диапазоном 0–100. Первый выбор является подмножеством рекомендаций и получает дополнительный вес. Порядок списка, жирное выделение или одно повторение не доказывают первый выбор, а несколько продуктов одного бренда в одном ответе не приносят дополнительных баллов.
В десяти гипотетических ответах с одинаковым весом бренд, нейтрально упомянутый во всех десяти, получает 20. Бренд, рекомендованный в трёх, отсутствующий в семи и ни разу не названный первым выбором, получает 21: 20 × 0.3 + 50 × 0.3. Разница отражает акцент политики оценки на рекомендациях; ни одно число не является вероятностью покупки.
Повторные выборки усредняются внутри каждой пары «вопрос–платформа», затем пары получают одинаковый вес. Полный ответ без названных брендов остаётся в знаменателе. До показа оценок и мест все запланированные образцы должны быть корректны и проанализированы совместимым методом. Незавершённому сбору не присваивается ноль, а приведённый выше пример цитирований 4/16 не даёт наблюдению права на рейтинг GEO50.
Неоднозначные или противоречивые рекомендации сохраняют неопределённую оценку, а не предполагаемый положительный или отрицательный сигнал. Поэтому оценка обобщает подтверждённые сигналы в рамках этой политики. Это не уровень уверенности, не оценка доли рынка и не рейтинг качества продукта.

Текущая политика оценки GEO50, сверенная с реализацией. Первый выбор добавляет вес рекомендации; неоднозначные сигналы остаются неопределёнными. Это не формула, предписанная цитируемыми исследованиями. Открыть схему в полном размере.
Сравнивайте наблюдения на одинаковых условиях
Более высокая оценка становится информативной, когда сравнение сохраняет смысл измерения. Предложенный в обзоре исследовательский протокол сочетает повторные измерения, перефразирование, контрольные группы и проверку человеком. Он также отмечает, что ответы сгруппированы по вопросам, источникам и датам: если считать каждый ответ независимым предпочтением клиента, неопределённость можно занизить. Martinez
Для бизнес-отчёта ведите краткую запись условий сравнения:
| Измерение | Что показывать |
|---|---|
| Вопросы | Точные формулировки, намерение клиента и метод выбора |
| Условия | Платформа, интерфейс продукта, язык, целевой рынок и время |
| Выборка | Запланированные, пригодные и неудачные наблюдения для каждого вопроса и платформы |
| Изменение | Версии страниц, дата вмешательства и неизменённая контрольная группа, где возможно |
| Доказательства | Оригинальные ответы, URL источников и проверки автоматических суждений |
Проведите пилот, чтобы оценить вариативность и выбрать глубину выборки под решение. Увеличение числа ответов без улучшения охвата вопросов или согласованности сбора всё ещё может дать вводящий в заблуждение результат. Текущий рейтинг GEO50 не показывает статистические доверительные интервалы и не устанавливает причинный эффект правки.
Используйте рейтинг, чтобы выбрать, что исследовать
Слабый результат для важной потребности клиента может направить внимание на отсутствующие факты о продукте, неясное позиционирование или более сильные ответы конкурентов. Сильный результат может выявить объяснение, которое стоит сохранять. Перед выбором действия просмотрите реальные ответы и сравнивайте наблюдения с учётом набора вопросов и метода оценки.
Отделяйте бизнес-контекст от технически проверенного. Выбор рынка выражает целевой контекст покупки, но сам по себе не воспроизводит среду местного пользователя. Трафик функций ИИ Google включён в общую веб-отчётность Search Console, поэтому этот итог не является отдельным числом цитирований ИИ. Аналитика сайта и обращения клиентов добавляют свидетельства бизнес-результатов. Google Search Central
GEO50 показывает условия наблюдения и полноту сбора, а текущий скачиваемый файл содержит завершённый рейтинг, а не полный архив ответов. Используйте его, чтобы находить заслуживающие изучения закономерности, затем прослеживайте доказательства в ответах и опыте клиентов. Наше руководство по подготовке сайта объясняет, как превратить вывод в конкретное улучшение контента.
Источники и примечание редакции
- Google Search Central — Функции ИИ и ваш сайт ↗
Официальные рекомендации для Google AI Overviews и AI Mode; проверено 18 октября 2026 года. Требования платформы, а не экспериментальное исследование.
- Schulte, Bleeker и Kaufmann — Не измеряйте один раз: измерение видимости в поиске с ИИ (GEO) ↗
Препринт 2026 года, arXiv v1, 8 апреля. Разделы 3–6: пересечение источников и брендов во времени и при повторных запусках в четырёх системах. Швейцарский контекст сбора, выбранные отрасли кампаний, обнаружение брендов по подстрокам и фильтрация ограничивают обобщение.
- Liu, Zhang и Liang — Оценка проверяемости в генеративных поисковых системах ↗
Findings of EMNLP 2023; arXiv v2, 23 октября 2023 года. Разделы 2.3–2.4 и 4.2, а также ограничения: полнота и точность цитирования, различие между подтверждением источником и фактической истинностью. Историческая проверка, а не текущая оценка платформ.
- Martinez — Оптимизация видимости в генеративных системах: критический обзор GEO (2023–2026) ↗
Препринт обзора 2026 года, arXiv v1, 15 июля. Обобщение 45 исследований; разделы 3, 6 и 11 различают этапы процесса, результаты видимости и план измерения. Используйте как обобщение исследований, а не независимое экспериментальное подтверждение.
- Puerto и соавторы — C-SEO Bench: работает ли разговорное SEO? ↗
NeurIPS 2025, направление Datasets and Benchmarks. Разделы 4 и 6–7: две задачи, шесть областей, порядок цитирования и конкурирующие пользователи методов. Англоязычный тест; эксперименты с порядком контекста не показывают способ добиться такого порядка в действующей системе.