GEO 점수 해설: 숫자가 알려주는 것
가시성 점수가 무엇을 세고 얼마나 안정적인지, 관찰된 순위와 신뢰할 수 있는 사업 결론을 연구로 구분하는 방법.

업데이트
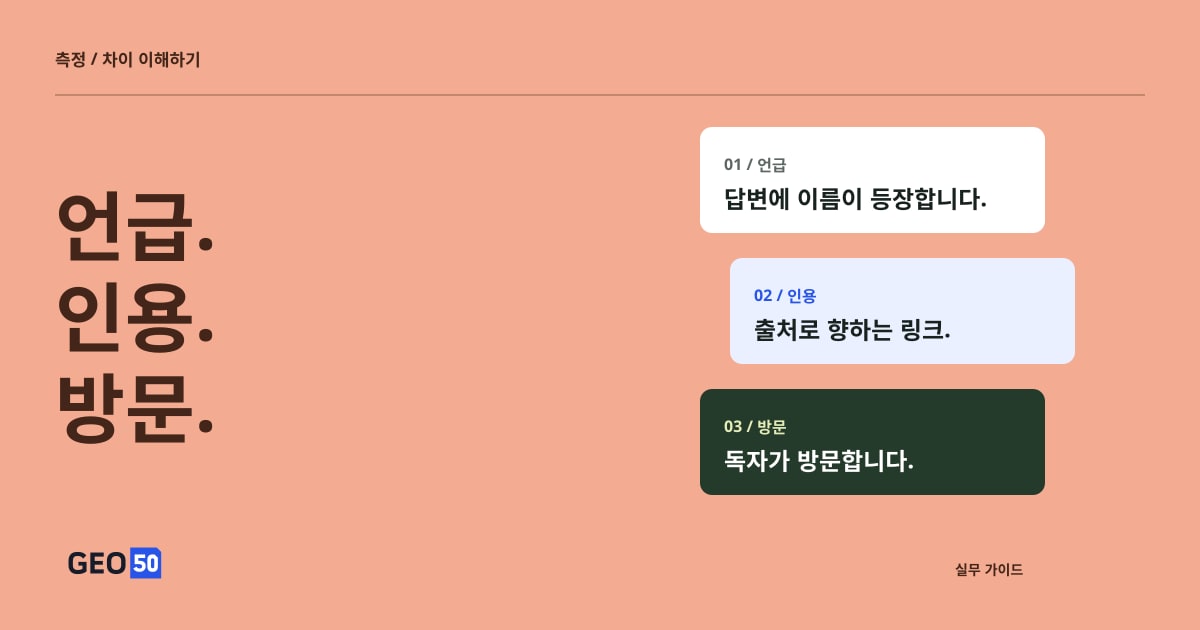
GEO 점수는 세는 사건, 그 바탕의 질문과 표본, 답변의 변동을 확인하며 읽으세요. 언급, 추천, 인용, 방문은 서로 다른 결과입니다. GEO50는 확인된 브랜드 신호를 합쳐 정해진 관찰의 순위를 만듭니다. 변화를 해석하려면 비교 가능한 조건과 근거도 필요합니다.
기억할 점
- 점수를 비교하기 전에 사건과 분모를 확인하세요.
- 반복 답변과 출처 확인으로 신뢰성을 평가하세요.
- 순위를 결정의 근거로 활용하되 제품 품질이나 입증된 편집 효과로 보지 마세요.
점수가 도와야 할 결정에서 시작하세요
사이트 업데이트 후 브랜드 점수가 오르면 곧바로 성공이라고 말하고 싶어집니다. 그러기 전에 답변에서 무엇이 달라졌는지 물으세요. 브랜드가 더 자주 등장했나요, 더 강하게 추천되었나요, 사이트 링크가 늘었나요? 서로 다른 개선입니다.
유용한 측정은 “관련 AI 답변이 이 고객 필요에 우리 제품을 추천하는가?” 같은 질문에서 시작합니다. 질문은 수집할 프롬프트, 셀 사건, 의미 있는 비교를 정합니다. 2026년 비판적 종합 검토는 데이터 수집 전에 목표 결과, 분모, 의미 있는 차이를 정하라고 명시합니다.
등장, 선호, 인용을 나누세요
“Acme는 여러 일정 관리 도구 중 하나입니다”는 언급입니다. “Acme는 이 대행사에 적합합니다”에는 추천이 추가됩니다. “이 요구에는 Acme가 첫 선택입니다”는 더 강한 선호입니다. 출처 링크는 별도 사건이며 자사, 독립 리뷰, 경쟁사로 향할 수 있습니다.
| 사건 | 근거가 보여야 할 것 |
|---|---|
| 언급 | 답변에 브랜드 이름이 등장 |
| 추천 | 답변이 적합한 선택으로 브랜드를 제안 |
| 첫 선택 | 답변이 명시적으로 최우선 선택이라고 밝힘 |
| 웹사이트 인용 | 자사 페이지를 가리키는 링크 |
이 구분은 연구 결과를 제목만으로 비교할 수 없는 이유이기도 합니다. C-SEO Bench는 인용 순서의 변화를 평가하며 브랜드의 언급 빈도나 명시적 추천 빈도와 다릅니다. 자동 보고서에서는 원답변 표본을 살펴 라벨이 실제 언어와 맞는지 확인하세요. URL 속 브랜드 이름이나 목록 첫 제품만으로 명시적인 첫 선택을 입증할 수 없습니다.
인용이 실제로 뒷받침하는 내용을 확인하세요
링크는 답변을 점검 가능하게 하지만 연결된 페이지가 주장을 뒷받침한다고 보장하지 않습니다. Liu, Zhang, Liang은 2023년 생성형 검색 엔진 연구에서 Bing Chat, NeevaAI, Perplexity, YouChat을 감사했습니다. 평가한 시스템 전체에서 생성된 진술의 51.5%가 인용으로 완전히 뒷받침되었고 인용의 74.5%가 연결된 진술을 뒷받침했습니다. 이는 과거 감사 결과이며 현재 플랫폼 정확도 추정이 아닙니다.
두 수치는 다른 질문을 다룹니다. 인용 재현율은 검증이 필요한 진술이 충분한 출처 지원을 받는가를 봅니다. 인용 정밀도는 붙은 인용이 답변의 주장을 뒷받침하는가를 봅니다. 둘 다 링크 수가 아닌 출처 확인이 필요합니다.
답변이 제품은 오프라인으로 작동하고 무료 온보딩을 포함한다고 말한다고 합시다. 오프라인 사용을 확인하는 페이지는 문장의 일부만 뒷받침합니다. 정확한 답으로 판단하기 전에 다른 주장, 해당 요금제, 날짜를 확인하세요. 완전한 출처 지원도 귀속 검증이지 출처 자체의 진실성 증명은 아닙니다. 기업이 실무적으로 볼 것은 기능과 조건이 전달 과정에서 유지되는가입니다.
분모를 드러내세요
20번 수집해 사용 가능한 답변 16개를 얻었고 그중 네 개가 자사 사이트를 인용했다고 합시다. 유효 답변의 인용률은 4/16, 즉 25%이고 수집 성공률은 16/20, 즉 80%입니다. 가상의 두 수치는 서로 다른 것을 설명합니다. “가시성 25%”만 보고하면 수집 실패를 숨기고 사건도 정의하지 않은 셈입니다.
브랜드 언급이 없는 완성된 답변은 실패한 요청과도 다릅니다. 전자는 관찰된 부재이고 후자는 근거의 부재입니다. 따로 기록하고 어떤 관찰이 각 지표에 들어가는지 밝히세요.
질문 선택도 그만큼 중요합니다. “Acme는 좋은 일정 관리 도구인가요?”는 이름을 지정한 브랜드에 대한 반응을 봅니다. “소규모 대행사에 맞는 도구는?”는 분야 안에서의 발견을 봅니다. 구분 없이 섞으면 질문만 바뀌어도 점수가 달라집니다. 생성 질문은 시험 집합이지 실제 고객이 각 질문을 얼마나 자주 하는지 측정한 것이 아닙니다.
답변 간 변동을 예상하세요
2026년 사전 공개 논문 Don’t Measure Once는 시간에 따른 관찰과 반복 실행으로 네 AI 검색 엔진을 살폈습니다. 24시간 이내 출처 분석에서 평균 Jaccard 중복률은 네 캠페인 분야에 걸쳐 약 32%–43%였습니다. Jaccard 중복률은 공통 출처를 두 출처 집합의 합집합과 비교하며 브랜드 언급률이나 답변의 정답 확률이 아닙니다.
분석은 엔진–프롬프트당 최대 열 번 반복하고 인용을 추출하지 못한 실행은 해당 출처 비교에서 제외했습니다. 수집 환경은 스위스였고 선택한 산업과 브랜드 탐지 규칙도 일반화를 제한합니다. 유용한 발견은 긴 시간 간격이나 사이트 편집 없이도 두 번째 답변이 크게 달라질 수 있다는 점입니다.
따라서 세 검사를 나눌 수 있습니다. 동일 질문을 반복해 실행 간 변동을 보고, 뜻이 같은 표현으로 문구 민감도를 보고, 고정 질문 집합을 시간에 따라 반복해 변화를 봅니다. 세 검사에서 유지되는 결과는 유리한 화면 한 장보다 유익합니다.
GEO50가 브랜드 신호를 점수로 바꾸는 방법
GEO50는 단일 턴 AI 답변 표본에서 확인된 브랜드 신호를 요약합니다. 현재 공식은 자체 채점 정책이며 인용한 논문이 정한 공식이 아닙니다. 웹사이트 인용, 유입 방문, 인용 품질은 점수에 포함하지 않습니다.
| 신호 | 기여도 |
|---|---|
| 답변에 브랜드 등장 | 20 × 언급률 |
| 브랜드를 명시적으로 추천 | 50 × 추천률 |
| 브랜드를 명시적으로 첫 선택으로 지정 | 30 × 첫 선택률 |
| 브랜드를 명시적으로 비추천 | −50 × 비추천률 |
비율은 0에서 1을 쓰고 기여도를 더해 결과를 0–100으로 제한합니다. 첫 선택은 추천의 부분집합이며 추가 가중치를 받습니다. 목록 순서, 굵은 글씨, 반복만으로 첫 선택을 판단하지 않으며, 한 답변에 같은 브랜드의 제품이 여러 개여도 가산점은 없습니다.
가상의 동일 가중치 답변 열 개에서 모두 중립적으로 언급된 브랜드는 20점입니다. 세 개에서 추천되고 일곱 개에서 빠졌으며 첫 선택은 없었던 브랜드는 21점, 즉 20 × 0.3 + 50 × 0.3입니다. 차이는 추천을 강조하는 채점 정책을 반영하며 어느 숫자도 구매 확률이 아닙니다.
반복 표본은 질문–플랫폼 조합 안에서 평균하고 각 조합에 동일한 가중치를 줍니다. 브랜드가 없는 완성 답변도 분모에 남습니다. 예정한 모든 표본이 유효하고 호환되는 방법으로 분석되어야 점수와 순위를 표시합니다. 불완전 수집을 0점으로 처리하지 않으며 앞의 4/16 인용 예시는 GEO50 순위의 자격을 충족하지 못합니다.
모호하거나 상충하는 추천은 긍정·부정을 추정하지 않고 불확실한 판단으로 남깁니다. 따라서 점수는 정책 아래 확인된 신호의 요약입니다. 신뢰 수준, 시장점유율 추정, 제품 품질 평가가 아닙니다.

구현과 대조한 GEO50의 현재 채점 정책입니다. 첫 선택은 추천에 가중치를 더하고 모호한 신호는 불확실하게 남깁니다. 인용 논문이 정한 공식이 아닙니다. 원본 크기 도표 보기.
같은 기준으로 관찰을 비교하세요
더 높은 점수가 유익하려면 비교가 측정의 의미를 유지해야 합니다. 종합 검토가 제안한 연구 절차는 반복 측정, 바꿔 말하기, 통제 조건, 사람의 검증을 결합합니다. 또한 답변은 질문·출처·날짜별로 묶이므로 각 출력을 독립적인 고객 선호로 다루면 불확실성을 과소평가할 수 있다고 지적합니다. Martinez
사업 보고서에는 간결한 비교 기록을 남기세요.
| 차원 | 드러낼 내용 |
|---|---|
| 질문 | 정확한 문구, 고객 의도, 선정 방법 |
| 조건 | 플랫폼, 제품 이용 화면, 언어, 목표 시장, 시점 |
| 표본 | 질문·플랫폼별 예정, 사용 가능, 실패 관찰 |
| 변화 | 페이지 버전, 개입일, 가능하면 무처리 비교 대상 |
| 근거 | 원답변, 출처 URL, 자동 판단 확인 |
예비 조사로 변동을 평가하고 결정에 맞는 표본 깊이를 선택하세요. 질문 범위나 수집 일관성을 개선하지 않고 개수만 늘려도 오해를 낳을 수 있습니다. 현재 GEO50 순위는 통계적 신뢰구간을 표시하거나 편집의 인과 효과를 입증하지 않습니다.
순위로 조사할 대상을 결정하세요
관련 고객 필요에서 약한 결과는 빠진 제품 사실, 불명확한 포지셔닝, 더 강한 경쟁 답변에 주의를 돌릴 수 있습니다. 강한 결과는 유지할 가치가 있는 설명을 찾아줍니다. 행동을 정하기 전에 실제 답변을 검토하고 질문 집합과 채점 방법을 고려해 관찰을 비교하세요.
사업 맥락과 기술적으로 검증한 것을 구분하세요. 시장 선택은 목표 구매 맥락을 나타낼 뿐 현지 사용자 환경을 재현하지는 않습니다. Google AI 기능 트래픽은 Search Console의 전체 웹 보고에 포함되므로 그 합계는 AI 인용만의 수치가 아닙니다. 사이트 분석과 고객 문의는 사업 성과의 추가 근거입니다. Google Search Central
GEO50는 관찰 범위와 수집 완성도를 표시하며 현재 다운로드에는 전체 답변 아카이브가 아닌 완성된 순위가 담깁니다. 조사할 패턴을 찾고 근거를 따라 답변과 고객 경험을 살펴보세요. 웹사이트 준비 가이드는 발견을 명확한 콘텐츠 개선으로 바꾸는 방법을 설명합니다.
출처 및 편집 참고 사항
- Google Search Central — AI 기능과 웹사이트 ↗
Google AI Overviews 및 AI Mode의 공식 지침. 2026년 10월 18일 확인. 실험 연구가 아닌 플랫폼 요건입니다.
- Schulte, Bleeker, Kaufmann — 한 번만 측정하지 말라: AI 검색의 가시성 측정(GEO) ↗
2026년 사전 공개 논문, arXiv v1, 4월 8일. 3–6절: 네 엔진의 장기 관찰 및 반복 실행에서 출처·브랜드 중복. 스위스 수집 환경, 선택된 캠페인 분야, 부분 문자열 브랜드 탐지, 필터링이 일반화를 제한합니다.
- Liu, Zhang, Liang — 생성형 검색 엔진의 검증 가능성 평가 ↗
Findings of EMNLP 2023; arXiv v2, 2023년 10월 23일. 2.3–2.4절, 4.2절 및 한계: 인용 재현율, 인용 정밀도, 출처의 뒷받침과 사실적 진실의 차이. 과거 감사이며 현재 플랫폼 평가표가 아닙니다.
- Martinez — 생성형 엔진의 가시성 최적화: 생성형 엔진 최적화의 비판적 종합 검토(2023–2026) ↗
2026년 종합 검토 사전 공개 논문, arXiv v1, 7월 15일. 45개 연구 종합. 3절, 6절, 11절은 처리 단계, 가시성 결과, 측정 설계를 구분합니다. 독립적인 실험 확인이 아닌 연구 종합으로 활용하세요.
- Puerto 외 — C-SEO Bench: 대화형 SEO는 효과가 있는가? ↗
NeurIPS 2025, Datasets and Benchmarks Track. 4절 및 6–7절: 두 과제, 여섯 영역, 인용 순위, 경쟁하는 도입자. 영어 벤치마크이며 문맥 순서 실험은 실제 엔진에서 그 순서를 얻는 방법을 입증하지 않습니다.