GEO-scores uitgelegd: wat het getal vertelt
Begrijp wat zichtbaarheidsscores tellen, hun stabiliteit en hoe onderzoek een observatie van een betrouwbare zakelijke conclusie onderscheidt.

Bijgewerkt
Controleer bij GEO-scores evenement, vragen, samples en antwoordvariatie. Vermeldingen, aanbevelingen, citaten en bezoeken zijn verschillend. GEO50 combineert bevestigde signalen tot een ranglijst voor een bepaalde observatie; verandering duiden vraagt vergelijkbare voorwaarden en onderliggend bewijs.
Belangrijkste inzichten
- Bepaal evenement en noemer voordat je scores vergelijkt.
- Gebruik herhaalde antwoorden en broncontroles voor betrouwbaarheid.
- Behandel ranglijsten als beslisbewijs, niet als productkwaliteit of bewezen bewerkingseffect.
Begin bij de beslissing die de score moet ondersteunen
Een merkscore stijgt na een website-update. De verleiding is de update succesvol te noemen. Vraag eerst wat de antwoorden veranderde: vaker genoemd, sterker aanbevolen of meer links? Dat zijn verschillende verbeteringen.
Een nuttige meting begint met ‘Bevelen relevante AI-antwoorden ons product aan voor deze klantbehoefte?’. Dat bepaalt prompts, geteld evenement en betekenisvolle vergelijking. Het kritische overzicht uit 2026 stelt expliciet: bepaal uitkomst, noemer en betekenisvol verschil vóór dataverzameling.
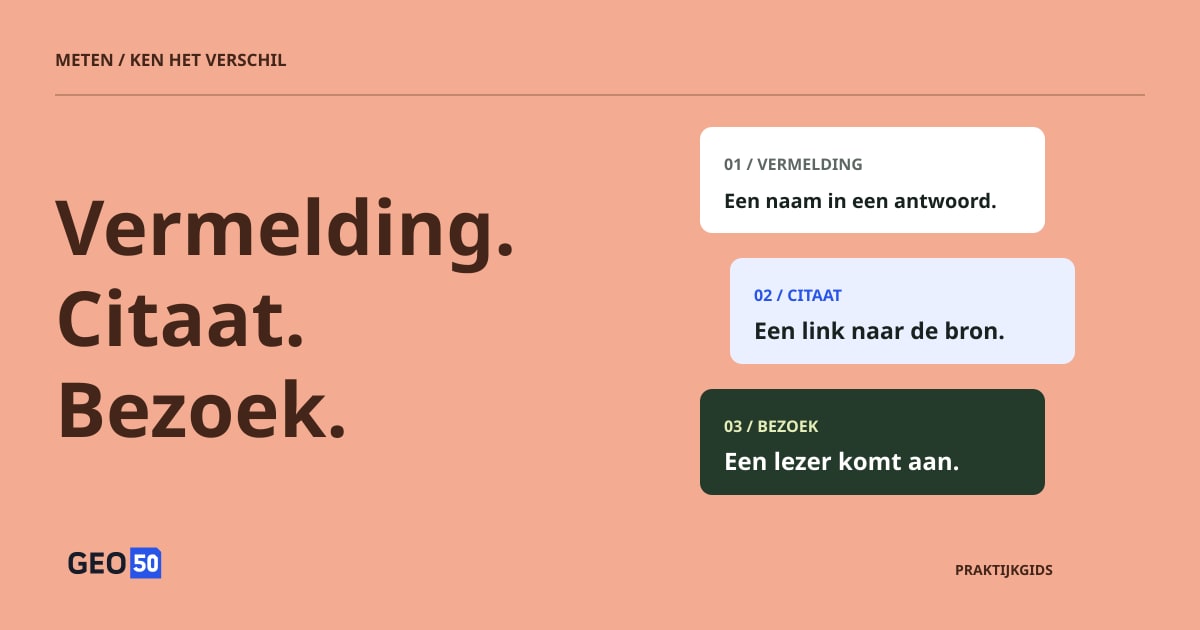
Scheid aanwezigheid, voorkeur en citatie
‘Acme is een van verschillende planningstools’ is een vermelding. ‘Acme is geschikt voor dit bureau’ voegt een aanbeveling toe. ‘Acme is mijn eerste keuze voor deze eisen’ drukt sterkere voorkeur uit. Een bronlink is apart en kan naar bedrijf, onafhankelijke review of concurrent verwijzen.
| Evenement | Wat bewijs moet tonen |
|---|---|
| Vermelding | Het merk wordt genoemd |
| Aanbeveling | Het antwoord stelt het merk voor als geschikte keuze |
| Eerste keuze | Het antwoord noemt het expliciet de beste keuze |
| Websitecitaat | Een link wijst naar een eigen bedrijfspagina |
Daarom kun je onderzoeken niet alleen via koppen vergelijken. C-SEO Bench meet citatievolgorde, niet hoe vaak merken worden genoemd of expliciet aanbevolen. Controleer bij automatische rapportage een steekproef van oorspronkelijke antwoorden. Een merknaam in een URL of eerste lijstpositie bewijst geen expliciete eerste keuze.
Controleer wat een citaat daadwerkelijk ondersteunt
Een link maakt controle mogelijk, maar bewijst geen bronondersteuning. In hun onderzoek naar generatieve zoekmachines uit 2023 onderzochten Liu, Zhang en Liang Bing Chat, NeevaAI, Perplexity en YouChat. Van de gegenereerde uitspraken was 51.5% volledig ondersteund, terwijl 74.5% van de citaten hun bijbehorende uitspraken steunde. Dit zijn historische auditresultaten, geen schattingen van huidige nauwkeurigheid.
De getallen beantwoorden andere vragen. Citatiedekking vraagt of controlebehoeftige uitspraken volledige bronnensteun hebben. Precisie vraagt of bijgevoegde citaten ondersteunen wat het antwoord zegt. Beide vereisen bronnenonderzoek, geen linktelling.
Stel dat een product offline werkt en gratis introductie biedt volgens het antwoord. Een pagina die offlinegebruik bevestigt, steunt maar een deel. Controleer de andere claim, het abonnement en de datum. Volledige ondersteuning test toeschrijving, niet waarheid van de bron zelf. Het bedrijf moet controleren of mogelijkheden en voorwaarden de navertelling overleven.
Maak de noemer zichtbaar
Stel: 20 pogingen leveren 16 bruikbare antwoorden, waarvan vier de bedrijfssite citeren. De citatieratio is 4/16 of 25%; verzamelingssucces 16/20 of 80%. Dit zijn hypothetische cijfers over verschillende zaken. Alleen ‘25% zichtbaarheid’ melden verbergt fouten en definieert het evenement niet.
Een voltooid antwoord zonder merk verschilt ook van een mislukte aanvraag. Het eerste is waargenomen afwezigheid, het tweede ontbrekend bewijs. Noteer beide apart en vermeld wat in elke meetwaarde komt.
Vragenselectie telt evenzeer. ‘Is Acme een goede planningstool?’ test reactie op een genoemd merk. ‘Welke tools passen bij een klein bureau?’ test categorieontdekking. Ongescheiden mengen verandert scores alleen door andere vragen. Gegenereerde vragen zijn een testset, geen meting van echte klantvraagfrequentie.
Verwacht variatie tussen antwoorden
Don’t Measure Once, een preprint uit 2026, onderzocht vier AI-zoekmachines met observaties door de tijd en herhalingen. Binnen 24 uur varieerde de gemiddelde Jaccard-overlap van bronnen ongeveer van 32% tot 43% over vier campagnecategorieën. Jaccard vergelijkt gedeelde bronnen met de vereniging van twee sets; het is geen merkvermeldingsratio of kans op juistheid.
De analyse gebruikte maximaal tien herhalingen per zoekmachine–prompt en sloot runs zonder geëxtraheerde citaten uit die bronnenvergelijking. De Zwitserse context, gekozen sectoren en merkdetectieregels beperken generalisatie. Het nuttige inzicht: een tweede antwoord kan sterk verschillen zonder lange tussenperiode of websitebewerking.
Dat suggereert drie controles: identieke vragen herhalen voor runvariatie, equivalente formuleringen voor woordgevoeligheid en een vaste set door de tijd voor verandering. Een resultaat dat alle drie doorstaat zegt meer dan één gunstige schermafbeelding.
Hoe GEO50 merksignalen omzet in een score
GEO50 vat bevestigde signalen samen in verzamelde AI-antwoorden met één beurt. De huidige formule is ons scorebeleid, niet voorgeschreven door de geciteerde artikelen. Websitecitaten, verwijzingsbezoeken en citatiekwaliteit vallen erbuiten.
| Signaal | Bijdrage |
|---|---|
| Merk verschijnt in antwoord | 20 × vermeldingsratio |
| Merk wordt expliciet aanbevolen | 50 × aanbevelingsratio |
| Merk is expliciet eerste keuze | 30 × eerstekeuzeratio |
| Merk wordt expliciet afgeraden | −50 × afraadratio |
Gebruik ratio’s van 0 tot 1, tel bijdragen op en begrens op 0–100. Eerste keuze is een subset van aanbeveling met extra gewicht. Lijstvolgorde, vetdruk of herhaling alleen volstaat niet; meerdere producten van één merk in een antwoord geven geen extra punten.
In tien hypothetische gelijkgewogen antwoorden scoort een overal neutraal genoemd merk 20. Een merk aanbevolen in drie, afwezig in zeven en nooit eerste keuze scoort 21: 20 × 0.3 + 50 × 0.3. Dat weerspiegelt beleidsnadruk op aanbeveling; geen getal is koopkans.
Herhaalde samples worden gemiddeld per vraag–platformcombinatie; combinaties tellen gelijk. Een volledig antwoord zonder merken blijft in de noemer. Alle geplande samples moeten geldig en met compatibele methode geanalyseerd zijn voordat scores en posities verschijnen. Onvolledige verzameling krijgt geen nul; het eerdere 4/16-citatievoorbeeld kwalificeert niet voor een GEO50-ranglijst.
Dubbelzinnige of tegenstrijdige aanbevelingen blijven onzeker, niet verondersteld positief of negatief. De score vat bevestigde signalen onder dit beleid samen. Het is geen betrouwbaarheidsniveau, marktdeelraming of productkwaliteitscijfer.

Huidig GEO50-scorebeleid, gecontroleerd tegen de implementatie. Eerste keuze voegt gewicht toe; dubbelzinnige signalen blijven onzeker. De formule is niet voorgeschreven door de artikelen. Bekijk het volledige diagram.
Vergelijk onder gelijke voorwaarden
Een hogere score informeert als de vergelijking de meetbetekenis behoudt. Het voorgestelde protocol combineert herhalingen, parafrases, controles en menselijke validatie. Antwoorden zijn ook gegroepeerd naar vragen, bronnen en datums: elke uitvoer als onafhankelijke klantvoorkeur behandelen kan onzekerheid onderschatten. Martinez
Bewaar voor bedrijfsrapportage een compact vergelijkingslog:
| Dimensie | Zichtbaar houden |
|---|---|
| Vragen | Exacte tekst, klantintentie en selectiemethode |
| Voorwaarden | Platform, productinterface, taal, doelmarkt en tijd |
| Samples | Geplande, bruikbare en mislukte observaties per vraag en platform |
| Verandering | Paginaversies, interventiedatum en onbehandelde vergelijking waar haalbaar |
| Bewijs | Oorspronkelijke antwoorden, bron-URL’s en controles van automatische oordelen |
Gebruik een pilot voor variabiliteit en steekproefdiepte. Meer aantallen zonder betere vraagdekking of verzamelconsistentie kunnen nog steeds misleiden. De huidige GEO50-ranglijst toont geen statistische betrouwbaarheidsintervallen en stelt geen causaal bewerkingseffect vast.
Gebruik de ranglijst om onderzoek te kiezen
Een zwak resultaat voor een relevante behoefte kan wijzen op ontbrekende productfeiten, onduidelijke positionering of sterkere concurrentieantwoorden. Een beter resultaat kan een te behouden uitleg aanwijzen. Bekijk echte antwoorden vóór maatregelen en vergelijk met vragenset en scoremethode in beeld.
Scheid zakelijke context van technische verificatie. Een markt kiezen geeft koopcontext aan, maar bootst geen lokale gebruikersomgeving na. Googles AI-verkeer valt binnen algemene Web-rapporten in Search Console; het totaal is geen aparte citatietelling. Webanalyse en klantvragen leveren aanvullend zakelijk bewijs. Google Search Central
GEO50 toont reikwijdte en volledigheid; de huidige download bevat de volledige ranglijst, niet het hele antwoordarchief. Vind hiermee patronen en volg het bewijs naar antwoorden en klantervaring. Onze websitevoorbereidingsgids legt de omzetting naar een concrete inhoudsverbetering uit.
Bronnen en redactionele toelichting
- Google Search Central — AI-functies en je website ↗
Officiële richtlijnen voor Google AI Overviews en AI Mode; gecontroleerd op 18 oktober 2026. Platformeisen, geen experiment.
- Schulte, Bleeker en Kaufmann — Meet niet één keer: zichtbaarheid meten in AI-zoeken (GEO) ↗
Preprint 2026, arXiv v1, 8 april. Secties 3–6: longitudinale en herhaalde bron-/merkoverlap over vier systemen. Zwitserse context, gekozen sectoren, substringmerkdetectie en filtering beperken generalisatie.
- Liu, Zhang en Liang — Verifieerbaarheid van generatieve zoekmachines beoordelen ↗
Findings of EMNLP 2023; arXiv v2, 23 oktober 2023. Secties 2.3–2.4 en 4.2 en Beperkingen: citatiedekking, precisie en verschil tussen bronondersteuning en feitelijke waarheid. Historisch audit, geen actuele platformscorekaart.
- Martinez — Zichtbaarheid optimaliseren in generatieve systemen: een kritisch GEO-overzicht (2023–2026) ↗
Overzichtspreprint 2026, arXiv v1, 15 juli. Synthese van 45 studies; secties 3, 6 en 11 scheiden procesfasen, uitkomsten en meetontwerp. Gebruik als synthese, niet als onafhankelijke experimentele bevestiging.
- Puerto et al. — C-SEO Bench: werkt conversationele SEO? ↗
NeurIPS 2025, Datasets and Benchmarks. Secties 4 en 6–7: twee taken, zes domeinen, citatievolgorde en concurrerende toepassing. Engelstalige benchmark; contextvolgorde-experimenten tonen niet hoe je die volgorde op een live systeem verkrijgt.