Comprendre les scores GEO : ce que le chiffre peut vous apprendre
Comprenez ce que compte un score de visibilité, sa stabilité et comment la recherche distingue un classement observé d’une conclusion commerciale fiable.

Mis à jour
Lisez un score GEO en vérifiant l’événement compté, les questions et échantillons sous-jacents et la variabilité des réponses. Mentions, recommandations, citations et visites sont des résultats distincts. GEO50 combine les signaux de marque confirmés en un classement pour une observation définie ; interpréter un changement exige aussi des conditions comparables et les preuves correspondantes.
À retenir
- Identifiez l’événement et le dénominateur avant de comparer les scores.
- Utilisez des réponses répétées et des vérifications de sources pour évaluer la fiabilité.
- Considérez le classement comme un élément de décision, pas comme une mesure de qualité produit ou l’effet prouvé d’une modification.
Commencer par la décision que le score doit éclairer
Le score d’une marque augmente après une mise à jour du site. La tentation immédiate est de déclarer cette mise à jour réussie. Avant de le faire, demandez ce qui a changé dans les réponses sous-jacentes : la marque apparaît-elle plus souvent, reçoit-elle des recommandations plus fortes ou gagne-t-elle des liens vers son site ? Ce sont des améliorations différentes.
Une mesure utile commence par une question comme « Les réponses d’IA pertinentes recommandent-elles notre produit pour ce besoin client ? ». Cette question détermine les requêtes à collecter, l’événement à compter et la comparaison utile. La revue critique de 2026 l’explicite : définir le résultat visé, le dénominateur et la différence significative avant la collecte.
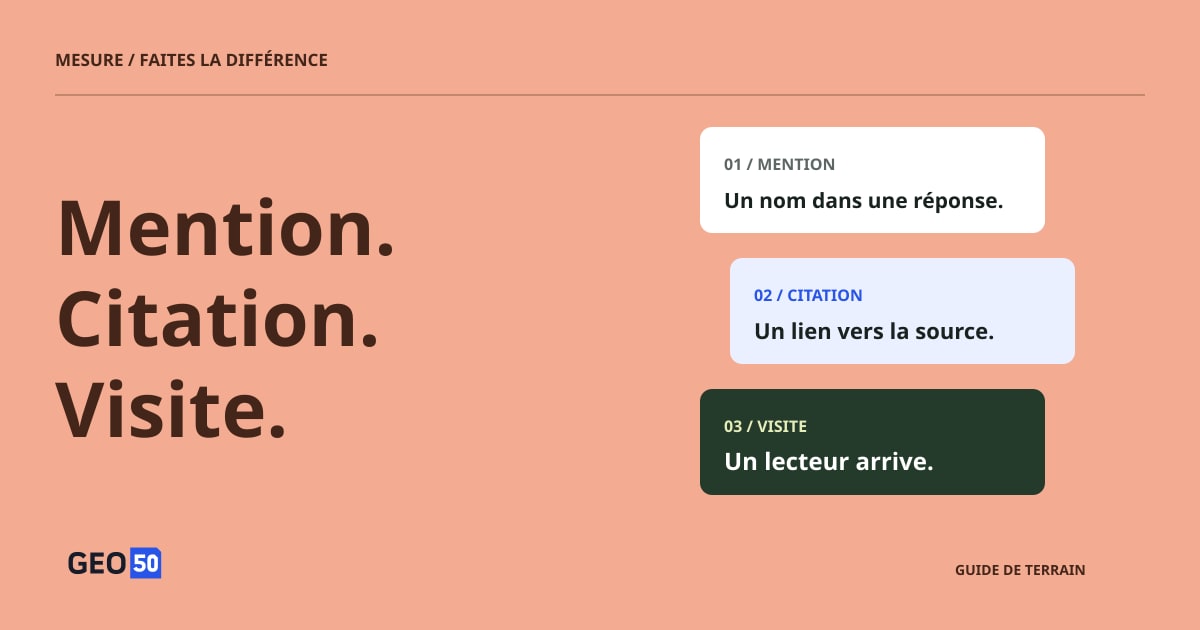
Distinguer présence, préférence et citation
Une réponse disant « Acme est l’un des outils de prise de rendez-vous » constitue une mention. « Acme convient à cette agence » ajoute une recommandation. « Acme est mon premier choix pour ces exigences » exprime une préférence plus forte. Un lien source est un événement distinct et peut pointer vers l’entreprise, un avis indépendant ou un concurrent.
| Événement | Ce que les preuves doivent montrer |
|---|---|
| Mention | La marque est nommée dans la réponse |
| Recommandation | La réponse propose la marque comme choix adapté |
| Premier choix | La réponse l’identifie explicitement comme meilleur choix |
| Citation du site | Un lien pointe vers une page propre à l’entreprise |
Cette distinction explique aussi pourquoi les résultats de recherche ne peuvent être comparés sur leur seul titre. C-SEO Bench évalue les changements d’ordre des citations ; ce résultat diffère de la fréquence de mention ou de recommandation explicite d’une marque. Dans un rapport automatisé, examinez un échantillon de réponses originales pour vérifier que les étiquettes correspondent au langage. Un nom de marque dans une URL ou un produit placé en tête de liste ne suffit pas à démontrer une recommandation explicite comme premier choix.
Vérifier ce qu’une citation étaye réellement
Un lien permet d’inspecter une réponse, mais ne prouve pas que la page liée étaye l’affirmation. Dans leur étude de 2023 sur les moteurs de recherche génératifs, Liu, Zhang et Liang ont audité Bing Chat, NeevaAI, Perplexity et YouChat. Parmi les systèmes évalués, 51.5% des affirmations générées étaient pleinement étayées par des citations, tandis que 74.5% des citations soutenaient les affirmations associées. Ce sont des résultats d’audit historiques, pas des estimations de la précision actuelle des plateformes.
Ces deux chiffres répondent à des questions distinctes. Le rappel des citations concerne le soutien complet des affirmations qui nécessitent une vérification. Leur précision concerne le fait que les citations jointes soutiennent bien ce que dit la réponse. Les deux exigent l’examen des sources, plutôt qu’un comptage de liens.
Supposons qu’une réponse affirme qu’un produit fonctionne hors ligne et inclut un accompagnement initial gratuit. Une page confirmant le fonctionnement hors ligne n’étaye qu’une partie de cette phrase. Vérifiez l’autre affirmation, l’offre concernée et la date avant de considérer la réponse comme exacte. Même un soutien complet des sources teste l’attribution, sans prouver que la source elle-même est vraie. Pour une entreprise, il faut surtout vérifier si ses capacités et conditions sont préservées dans la reformulation.
Rendre le dénominateur visible
Imaginons que 20 tentatives produisent 16 réponses exploitables, dont quatre citent le site de l’entreprise. Le taux de citation parmi les réponses exploitables est de 4/16, soit 25% ; le succès de collecte est de 16/20, soit 80%. Ces chiffres hypothétiques décrivent deux choses différentes. Annoncer seulement « 25% de visibilité » masque les échecs de collecte et laisse l’événement indéfini.
Une réponse complète sans mention de marque diffère également d’une requête échouée. La première constitue une absence observée ; la seconde, un manque de preuves. Enregistrez-les séparément et précisez quelles observations entrent dans chaque indicateur.
Le choix des questions compte tout autant. « Acme est-il un bon outil de prise de rendez-vous ? » teste une réaction à une marque nommée. « Quels outils conviennent à une petite agence ? » teste la découverte dans une catégorie. Les mélanger sans distinction peut modifier le score uniquement en changeant les questions. Les questions générées constituent un jeu de test ; elles ne mesurent pas la fréquence à laquelle les clients réels posent chacune d’elles.
S’attendre à une variation entre les réponses
Don’t Measure Once, prépublication de 2026, a examiné quatre moteurs de recherche par IA à l’aide d’observations dans le temps et d’exécutions répétées. Dans son analyse des sources à moins de 24 heures d’intervalle, le recouvrement moyen de Jaccard allait d’environ 32% à 43% pour les quatre catégories de campagnes. Ce recouvrement compare les sources communes à l’union des deux ensembles ; ce n’est ni un taux de mention de marque ni la probabilité qu’une réponse soit correcte.
L’analyse utilisait jusqu’à dix répétitions par couple moteur–requête et excluait de cette comparaison les exécutions sans citation extraite. Le contexte de collecte était suisse ; les secteurs sélectionnés et règles de détection de marques limitent encore la généralisation. Son résultat utile est qu’une deuxième réponse peut différer sensiblement même sans long intervalle ni modification du site.
Cela suggère trois vérifications distinctes : répéter la même question pour examiner la variation entre exécutions, employer des formulations équivalentes pour tester la sensibilité aux mots et répéter un ensemble fixe de questions au fil du temps pour observer le changement. Un résultat qui résiste aux trois est plus informatif qu’une capture d’écran favorable.
Comment GEO50 transforme les signaux de marque en score
GEO50 résume les signaux de marque confirmés dans des réponses d’IA échantillonnées à un seul tour. Sa formule actuelle est notre politique de notation, pas une formule imposée par les articles cités ici. Les citations de sites, visites référentes et la qualité des citations sont hors du score.
| Signal | Contribution |
|---|---|
| La marque apparaît dans la réponse | 20 × taux de mention |
| La marque est explicitement recommandée | 50 × taux de recommandation |
| La marque est explicitement le premier choix | 30 × taux de premier choix |
| La marque est explicitement déconseillée | −50 × taux de non-recommandation |
Utilisez des taux entre 0 et 1, additionnez les contributions et bornez le résultat à 0–100. Le premier choix est un sous-ensemble de la recommandation et reçoit un poids supplémentaire. L’ordre de liste, le gras ou la répétition seuls n’établissent pas un premier choix, et plusieurs produits d’une même marque dans une réponse ne donnent pas de points supplémentaires.
Pour dix réponses hypothétiques de même poids, une marque mentionnée de façon neutre dans les dix obtient 20. Une marque recommandée dans trois, absente dans sept et jamais désignée comme premier choix obtient 21 : 20 × 0.3 + 50 × 0.3. Cette différence reflète l’importance accordée à la recommandation par la politique de notation ; aucun des deux chiffres n’est une probabilité d’achat.
Les échantillons répétés sont moyennés dans chaque combinaison question–plateforme, puis ces combinaisons reçoivent le même poids. Une réponse complète ne nommant aucune marque reste dans le dénominateur. Tous les échantillons prévus doivent être valides et analysés avec une méthode compatible avant l’affichage des scores et rangs. Une collecte incomplète ne reçoit pas zéro, et l’exemple de citation 4/16 ci-dessus ne suffit pas à qualifier une observation pour un classement GEO50.
Les recommandations ambiguës ou contradictoires gardent un jugement incertain, plutôt qu’un signal positif ou négatif présumé. Le score résume donc les signaux confirmés selon cette politique. Ce n’est ni un niveau de confiance, ni une estimation de part de marché, ni une note de qualité produit.

Politique actuelle de notation GEO50, vérifiée par rapport à l’implémentation. Le premier choix renforce une recommandation ; les signaux ambigus restent incertains. Cette formule n’est pas prescrite par les articles cités. Voir le schéma en grand format.
Comparer les observations sur les mêmes bases
Un score supérieur devient informatif lorsque la comparaison conserve le sens de la mesure. Le protocole proposé par la revue combine mesures répétées, paraphrases, contrôles et validation humaine. Il note aussi que les réponses sont regroupées par questions, sources et dates : traiter chaque sortie comme une préférence client indépendante peut sous-estimer l’incertitude. Martinez
Pour un rapport commercial, conservez un registre de comparaison compact :
| Dimension | Éléments à rendre visibles |
|---|---|
| Questions | Formulation exacte, intention du client et méthode de sélection |
| Conditions | Plateforme, interface du produit, langue, marché visé et moment |
| Échantillons | Observations prévues, exploitables et échouées pour chaque question et plateforme |
| Changement | Versions des pages, date d’intervention et comparaison non traitée si possible |
| Preuves | Réponses originales, URL sources et vérifications des jugements automatisés |
Utilisez un pilote pour évaluer la variabilité et choisir la profondeur d’échantillonnage adaptée à la décision. Augmenter le nombre sans améliorer la couverture des questions ou la cohérence de collecte peut toujours produire un résultat trompeur. Le classement actuel de GEO50 n’affiche pas d’intervalles de confiance statistiques et n’établit pas l’effet causal d’une modification.
Utiliser le classement pour choisir ce qu’il faut examiner
Un résultat faible pour un besoin client pertinent peut attirer l’attention sur des faits produit manquants, un positionnement flou ou des réponses concurrentes plus solides. Un meilleur résultat peut révéler une explication à préserver. Examinez les réponses réelles avant de décider de l’action suivante et comparez les observations en gardant leurs questions et méthodes de notation à l’esprit.
Distinguez le contexte commercial de ce qui a été techniquement vérifié. Choisir un marché exprime le contexte d’achat visé ; cela ne reproduit pas à lui seul l’environnement d’un utilisateur local. Le trafic des fonctionnalités d’IA de Google est inclus dans les rapports Web globaux de Search Console ; ce total n’est donc pas un décompte distinct des citations d’IA. L’analyse du site et les demandes clients ajoutent d’autres preuves sur les résultats commerciaux. Google Search Central
GEO50 montre le périmètre et la complétude de la collecte ; son téléchargement actuel contient le classement complet plutôt que l’archive intégrale des réponses. Utilisez-le pour repérer les tendances à examiner, puis suivez les preuves dans les réponses et l’expérience client. Notre guide de préparation du site explique comment transformer une observation en amélioration de contenu définie.
Sources et note éditoriale
- Google Search Central — Fonctionnalités d’IA et votre site web ↗
Consignes officielles pour Google AI Overviews et AI Mode ; vérifiées le 18 octobre 2026. Exigences de plateforme, pas étude expérimentale.
- Schulte, Bleeker et Kaufmann — Ne mesurez pas une seule fois : mesurer la visibilité dans la recherche par IA (GEO) ↗
Prépublication de 2026, arXiv v1, 8 avril. Sections 3–6 : recouvrement longitudinal et entre répétitions des sources et marques dans quatre moteurs. Le contexte suisse, les secteurs sélectionnés, la détection des marques par sous-chaînes et le filtrage limitent la généralisation.
- Liu, Zhang et Liang — Évaluer la vérifiabilité des moteurs de recherche génératifs ↗
Findings of EMNLP 2023 ; arXiv v2, 23 octobre 2023. Sections 2.3–2.4 et 4.2, et Limites : rappel et précision des citations, différence entre soutien des sources et vérité factuelle. Audit historique, pas tableau de performance actuel des plateformes.
- Martinez — Optimiser la visibilité dans les moteurs génératifs : revue critique du GEO (2023–2026) ↗
Prépublication de revue de 2026, arXiv v1, 15 juillet. Synthèse de 45 études ; les sections 3, 6 et 11 distinguent étapes du processus, résultats de visibilité et conception des mesures. À utiliser comme synthèse de recherche, pas comme confirmation expérimentale indépendante.
- Puerto et al. — C-SEO Bench : le SEO conversationnel fonctionne-t-il ? ↗
NeurIPS 2025, volet Datasets and Benchmarks. Sections 4 et 6–7 : deux tâches, six domaines, classement des citations et adoption concurrente. Évaluation en anglais ; les expériences sur l’ordre du contexte ne démontrent pas comment obtenir cet ordre dans un moteur réel.