Lue englanninkielinen alkuperäinen ↗
GEO-pisteet selitettynä: mitä luku voi kertoa
Ymmärrä, mitä näkyvyyspisteet laskevat, kuinka vakaita ne ovat ja miten tutkimus auttaa erottamaan havaitun sijoituksen luotettavasta liiketoimintapäätelmästä.

Päivitetty
Lue GEO-pisteitä tarkistamalla laskettava tapahtuma, taustalla olevat kysymykset ja näytteet sekä vastausten vaihtelu. Maininnat, suositukset, viittaukset ja käynnit kuvaavat eri tuloksia. GEO50 yhdistää vahvistetut brändisignaalit määritellyn havainnon rankingiksi; muutoksen tulkinta vaatii myös vertailukelpoiset olosuhteet ja taustalla olevan näytön.
Keskeiset opit
- Tunnista tapahtuma ja nimittäjä ennen pisteiden vertailua.
- Arvioi luotettavuutta toistettujen vastausten ja lähdetarkistusten avulla.
- Käsittele rankingia päätöksen näyttönä, älä tuotelaadun mittarina tai muokkauksen todistettuna vaikutuksena.
Aloita päätöksestä, jota pisteiden pitäisi tukea
Brändin pisteet nousevat verkkosivuston päivityksen jälkeen. Ensimmäinen houkutus on julistaa päivitys onnistuneeksi. Kysy ensin, mikä taustalla olevissa vastauksissa muuttui: esiintyikö brändi useammin, saiko se vahvempia suosituksia vai enemmän linkkejä sivustolleen? Nämä ovat erilaisia parannuksia.
Hyödyllinen mittaus alkaa esimerkiksi kysymyksestä ”Suosittelevatko asiaankuuluvat tekoälyvastaukset tuotettamme tähän asiakkaan tarpeeseen?” Kysymys määrittää kerättävät kehotteet, laskettavan tapahtuman ja merkityksellisen vertailun. Vuoden 2026 kriittinen katsaus toteaa tämän suoraan: määritä tavoiteltu tulos, nimittäjä ja merkityksellinen ero ennen tiedon keräämistä.
Erota esiintyminen mieltymyksestä ja viittauksesta
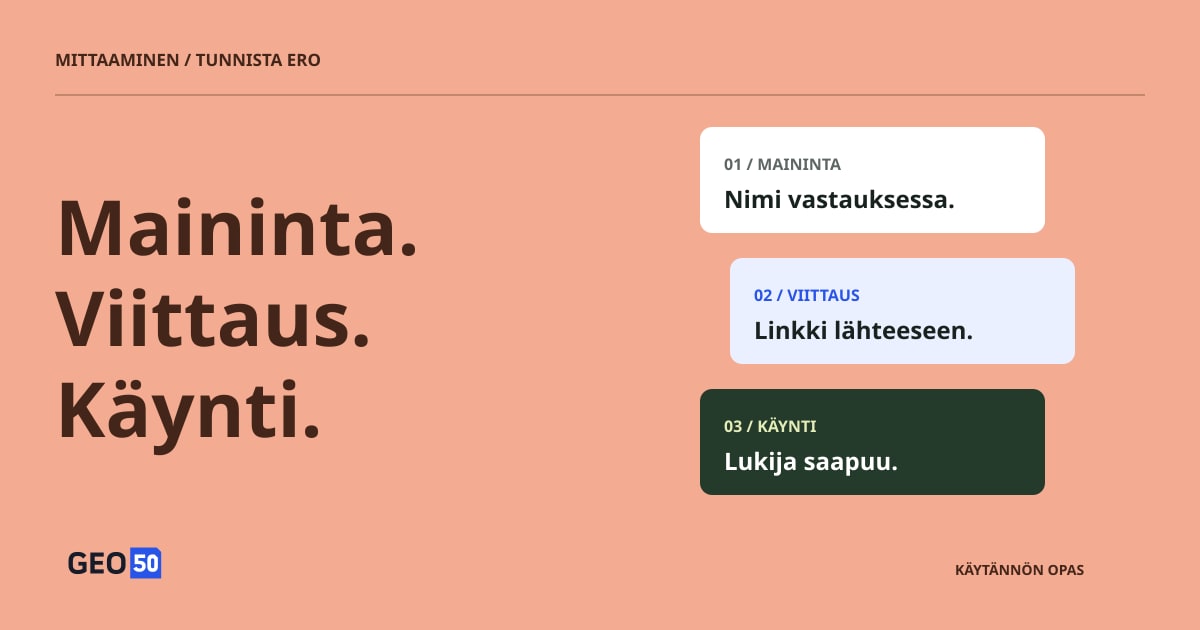
Vastaus ”Acme on yksi useista ajanvaraustyökaluista” osoittaa maininnan. ”Acme on sopiva valinta tälle toimistolle” lisää suosituksen. ”Acme on ensisijainen valintani näihin vaatimuksiin” ilmaisee vahvemman mieltymyksen. Lähdelinkki on erillinen tapahtuma, ja se voi osoittaa yritykseen, riippumattomaan arvioon tai kilpailijaan.
| Tapahtuma | Mitä näytön on osoitettava |
|---|---|
| Maininta | Brändi nimetään vastauksessa |
| Suositus | Vastaus ehdottaa brändiä sopivaksi valinnaksi |
| Ensisijainen valinta | Vastaus nimeää sen nimenomaisesti parhaaksi valinnaksi |
| Verkkosivustoviittaus | Linkki osoittaa yrityksen omalle sivulle |
Tämä ero selittää myös, miksi tutkimustuloksia ei voi vertailla pelkän otsikon perusteella. C-SEO Bench arvioi viittausjärjestyksen muutoksia; tulos eroaa siitä, kuinka usein brändi nimetään tai sitä suositellaan nimenomaisesti. Tarkista automaattisesta raportista otos alkuperäisiä vastauksia varmistaaksesi, että luokitukset vastaavat kieltä. Brändin nimi URL:ssa tai tuotteen esiintyminen listan ensimmäisenä ei riitä näytöksi nimenomaisesta ensisijaisesta suosituksesta.
Tarkista, mitä viittaus todella tukee
Linkki tekee vastauksesta tarkastettavan, mutta ei osoita linkitetyn sivun tukevan väitettä. Liu, Zhang ja Liang auditoivat vuoden 2023 generatiivisten hakukoneiden tutkimuksessaan Bing Chatia, NeevaAI:ta, Perplexityä ja YouChatia. Arvioiduissa järjestelmissä viittaukset tukivat täysin 51.5% tuotetuista väitteistä, ja 74.5% viittauksista tuki niihin liittyviä väitteitä. Nämä ovat historiallisia auditointituloksia, eivät arvioita alustojen nykyisestä tarkkuudesta.
Luvut vastaavat eri kysymyksiin. Viittausten saanti koskee sitä, saavatko tarkistusta tarvitsevat väitteet täyden lähdetuen. Viittausten tarkkuus koskee sitä, tukevatko liitetyt viittaukset vastauksen sanomaa. Molemmat vaativat lähteiden tutkimista pelkän linkkien laskemisen sijaan.
Oletetaan, että vastaus sanoo tuotteen toimivan offline-tilassa ja sisältävän ilmaisen käyttöönoton. Offline-käytön vahvistava sivu tukee vain osaa lauseesta. Tarkista toinen väite, sovellettava tilaustaso ja päivämäärä ennen kuin pidät vastausta täsmällisenä. Täydellinenkin lähdetuki testaa tiedon alkuperän osoittamista, ei todista itse lähdettä todeksi. Yrityksen käytännön tarkistus on, säilyvätkö sen ominaisuudet ja ehdot uudelleenkerronnassa.
Tee nimittäjä näkyväksi
Kuvitellaan, että 20 keruuyritystä tuottaa 16 käyttökelpoista vastausta, joista neljä viittaa yrityksen verkkosivustoon. Viittausosuus käyttökelpoisista vastauksista on 4/16 eli 25%; keruun onnistumisaste on 16/20 eli 80%. Nämä kuvitteelliset luvut kuvaavat kahta eri asiaa. Pelkkä ”25% näkyvyys” peittää keruun epäonnistumiset ja jättää tapahtuman määrittelemättä.
Valmis vastaus ilman brändimainintaa on myös eri asia kuin epäonnistunut pyyntö. Ensimmäinen on havaittu poissaolo, toinen puuttuva näyttö. Kirjaa ne erikseen ja kerro, mitkä havainnot sisältyvät kuhunkin mittariin.
Kysymysten valinta on yhtä tärkeää. ”Onko Acme hyvä ajanvaraustyökalu?” testaa vastausta nimettyyn brändiin. ”Mitkä työkalut sopivat pienelle toimistolle?” testaa löytämistä kategoriassa. Niiden sekoittaminen ilman erottelua voi muuttaa pisteitä pelkästään kysymyksiä muuttamalla. Tuotetut kysymykset muodostavat testijoukon; ne eivät mittaa, kuinka usein todelliset asiakkaat kysyvät kutakin kysymystä.
Odota vastausten välistä vaihtelua
Älä mittaa vain kerran, vuoden 2026 esijulkaisu, tarkasteli neljää tekoälyhakukonetta ajallisten havaintojen ja toistettujen ajokertojen avulla. Sen 24 tunnin sisäisessä lähdeanalyysissä keskimääräinen Jaccard-päällekkäisyys vaihteli noin 32%:sta 43%:iin neljässä kampanjakategoriassa. Jaccard-päällekkäisyys vertaa yhteisiä lähteitä kahden lähdejoukon yhdisteeseen; se ei ole brändin mainintaosuus eikä vastauksen oikeellisuuden todennäköisyys.
Analyysissä käytettiin enintään kymmentä toistoa hakukone–kehote-yhdistelmää kohti, ja ajot, joista ei saatu viittauksia, jätettiin lähdevertailusta pois. Keruuympäristö oli sveitsiläinen, ja valitut alat sekä brändintunnistussäännöt rajoittavat yleistämistä edelleen. Hyödyllinen havainto on, että toinen vastaus voi erota olennaisesti ilman pitkää aikaväliä tai verkkosivuston muokkaustakin.
Tämä puoltaa kolmea erillistä tarkistusta: toista sama kysymys ajokertojen vaihtelun tutkimiseksi, käytä vastaavia sanamuotoja sanamuotoherkkyyden tutkimiseksi ja toista kiinteä kysymysjoukko ajan mittaan muutoksen tutkimiseksi. Kaikki kolme tarkistusta kestävä tulos on informatiivisempi kuin yksi suotuisa kuvakaappaus.
Miten GEO50 muuttaa brändisignaalit pisteiksi
GEO50 tiivistää vahvistetut brändisignaalit otokseen kerätyistä yhden vuoron tekoälyvastauksista. Nykyinen kaava on oma pisteytyskäytäntömme, ei tässä viitattujen tutkimusten määräämä kaava. Verkkosivustoviittaukset, viittausliikenne ja viittausten laatu jäävät näiden pisteiden ulkopuolelle.
| Signaali | Vaikutus |
|---|---|
| Brändi esiintyy vastauksessa | 20 × mainintaosuus |
| Brändiä suositellaan nimenomaisesti | 50 × suositusosuus |
| Brändi on nimenomaisesti ensisijainen valinta | 30 × ensisijaisen valinnan osuus |
| Brändiä nimenomaisesti ei suositella | −50 × kielteisen suosituksen osuus |
Käytä osuuksia väliltä 0–1, laske vaikutukset yhteen ja rajaa tulos välille 0–100. Ensisijainen valinta on suosituksen osajoukko, joka saa lisäpainoa. Listajärjestys, lihavointi tai toisto ei yksin osoita ensisijaista valintaa, eivätkä saman brändin useat tuotteet yhdessä vastauksessa tuo lisäpisteitä.
Kymmenessä kuvitteellisessa, yhtä painotetussa vastauksessa brändi, joka mainitaan neutraalisti kaikissa kymmenessä, saa 20 pistettä. Brändi, jota suositellaan kolmessa, joka puuttuu seitsemästä ja jota ei koskaan nimetä ensisijaiseksi valinnaksi, saa 21 pistettä: 20 × 0.3 + 50 × 0.3. Ero kuvaa pisteytyskäytännön suosituspainotusta; kumpikaan luku ei ole ostotodennäköisyys.
Toistuvat näytteet keskiarvoistetaan kunkin kysymys–alusta-yhdistelmän sisällä, ja nämä yhdistelmät saavat saman painon. Täydellinen vastaus, jossa ei nimetä brändejä, pysyy nimittäjässä. Kaikkien suunniteltujen näytteiden on oltava kelvollisia ja yhteensopivalla menetelmällä analysoituja ennen pisteiden ja sijoitusten näyttämistä. Keskeneräiselle keruulle ei anneta nollaa, eikä aiempi 4/16-viittausesimerkki tee havainnosta kelvollista GEO50-rankingiin.
Monitulkintaiset tai ristiriitaiset suositukset säilyttävät epävarman arvion oletetun myönteisen tai kielteisen signaalin sijaan. Pisteet tiivistävät siten vahvistetut signaalit tämän käytännön mukaisesti. Ne eivät ole luottamustaso, markkinaosuusarvio tai tuotelaadun arvosana.

GEO50:n nykyinen pisteytyskäytäntö, tarkistettu toteutusta vasten. Ensisijainen valinta lisää suosituksen painoa; monitulkintaiset signaalit jäävät epävarmoiksi. Tämä ei ole viitattujen tutkimusten määräämä kaava. Näytä kaavio täysikokoisena.
Vertaa havaintoja samoilla ehdoilla
Korkeammat pisteet muuttuvat informatiivisiksi, kun vertailu säilyttää mittauksen merkityksen. Katsauksen ehdottama tutkimusprotokolla yhdistää toistuvat mittaukset, uudelleenmuotoilut, verrokit ja ihmisen varmistuksen. Se huomauttaa myös vastausten ryhmittyvän kysymysten, lähteiden ja päivämäärien mukaan: jokaisen tuotoksen käsittely itsenäisenä asiakasmieltymyksenä voi aliarvioida epävarmuutta. Martinez
Pidä yritysraporttia varten tiivis vertailutallenne:
| Ulottuvuus | Pidä näkyvissä |
|---|---|
| Kysymykset | Tarkka sanamuoto, asiakkaan tarkoitus ja valintamenetelmä |
| Olosuhteet | Alusta, tuotteen käyttöympäristö, kieli, tarkoitettu markkina ja ajankohta |
| Näytteet | Suunnitellut, käyttökelpoiset ja epäonnistuneet havainnot kysymys- ja alustakohtaisesti |
| Muutos | Sivuversiot, toimenpiteen päivämäärä ja mahdollisuuksien mukaan käsittelemätön verrokki |
| Näyttö | Alkuperäiset vastaukset, lähde-URL:t ja automaattisten arvioiden tarkistukset |
Arvioi vaihtelua pilotilla ja valitse päätökseen sopiva näytteenoton laajuus. Määrän lisääminen ilman parempaa kysymyskattavuutta tai keruun johdonmukaisuutta voi edelleen tuottaa harhaanjohtavan tuloksen. GEO50:n nykyinen ranking ei näytä tilastollisia luottamusvälejä eikä osoita muokkauksen syyvaikutusta.
Päätä rankingin avulla, mitä tutkia
Heikko tulos olennaisessa asiakastarpeessa voi ohjata huomion puuttuviin tuotefaktoihin, epäselvään asemointiin tai kilpailijoiden vahvempiin vastauksiin. Vahvempi tulos voi paljastaa säilyttämisen arvoisen selityksen. Tarkista todelliset vastaukset ennen jatkotoimen päättämistä ja vertaa havaintoja pitäen kysymysjoukon ja pisteytysmenetelmän näkyvissä.
Pidä liiketoimintatausta erillään teknisesti varmennetusta. Markkinan valinta ilmaisee tarkoitetun ostoympäristön; se ei itsessään toisinna paikallisen käyttäjän ympäristöä. Googlen tekoälyominaisuuksien liikenne sisältyy Search Consolen yleiseen Web-raportointiin, joten kokonaismäärä ei ole erillinen tekoälyviittausten lukumäärä. Sivustoanalytiikka ja asiakasyhteydenotot tuovat lisää näyttöä liiketoimintatuloksista. Google Search Central
GEO50 näyttää havainnon rajauksen ja keruun kattavuuden, ja nykyinen lataus sisältää valmiin rankingin koko vastausarkiston sijaan. Käytä sitä tutkittavien kuvioiden löytämiseen ja seuraa sitten näyttöä vastauksiin ja asiakaskokemukseen. Verkkosivuston valmisteluoppaamme selittää, miten havainto muutetaan määritellyksi sisältöparannukseksi.
Lähteet ja toimituksen huomautus
- Google Search Central — Tekoälyominaisuudet ja verkkosivustosi ↗
Viralliset ohjeet Google AI Overviewsiin ja AI Modeen; tarkistettu 18. lokakuuta 2026. Alustavaatimuksia, ei kokeellinen tutkimus.
- Schulte, Bleeker ja Kaufmann — Älä mittaa vain kerran: Näkyvyyden mittaaminen tekoälyhaussa (GEO) ↗
Vuoden 2026 esijulkaisu, arXiv v1, 8. huhtikuuta. Osiot 3–6: lähteiden ja brändien ajallinen ja toistettujen ajokertojen päällekkäisyys neljässä hakukoneessa. Sveitsiläinen keruuympäristö, valitut kampanja-alat, merkkijonojen osiin perustuva brändintunnistus ja suodatus rajoittavat yleistämistä.
- Liu, Zhang ja Liang — Todennettavuuden arviointi generatiivisissa hakukoneissa ↗
Findings of EMNLP 2023; arXiv v2, 23. lokakuuta 2023. Osiot 2.3–2.4 ja 4.2 sekä rajoitukset: viittausten saanti, viittausten tarkkuus ja lähdetuen ero tosiasialliseen totuuteen. Historiallinen auditointi, ei alustojen nykyinen tuloskortti.
- Martinez — Näkyvyyden optimointi generatiivisissa hakukoneissa: Kriittinen katsaus generatiivisten hakukoneiden optimointiin (2023–2026) ↗
Vuoden 2026 katsauksen esijulkaisu, arXiv v1, 15. heinäkuuta. Synteesi 45 tutkimuksesta; osiot 3, 6 ja 11 erottavat prosessin vaiheet, näkyvyystulokset ja mittausasetelman. Käytä tutkimussynteesinä, ei riippumattomana kokeellisena vahvistuksena.
- Puerto ym. — C-SEO Bench: Toimiiko keskusteleva SEO? ↗
NeurIPS 2025, Datasets and Benchmarks -osio. Osiot 4 ja 6–7: kaksi tehtävää, kuusi aihealuetta, viittaussijoitus ja kilpailevat käyttäjät. Englanninkielinen vertailuaineisto; kontekstijärjestyksen kokeet eivät osoita tapaa saavuttaa samaa järjestystä toimivassa hakukoneessa.