GEO 分数怎么读?从可见度到可信的判断
理解分数统计了什么、结果有多稳定,以及如何借助科研方法,把一次排名转化为有依据的业务判断。

更新于
解读 GEO 分数,要先看它统计的事件、背后的问题与样本,以及回答的波动。提及、推荐、引用和访问是不同的结果。GEO50 将已确认的品牌信号汇总为特定观察范围内的排名;要解释分数变化,还需要可比较的条件与原始证据。
关键要点
- 比较分数之前,先明确统计事件和分母。
- 结合重复回答与来源核查,判断结果的可靠性。
- 把排名用于支持决策,不把它当成产品质量或内容修改效果的证明。
先明确分数要支持什么决策
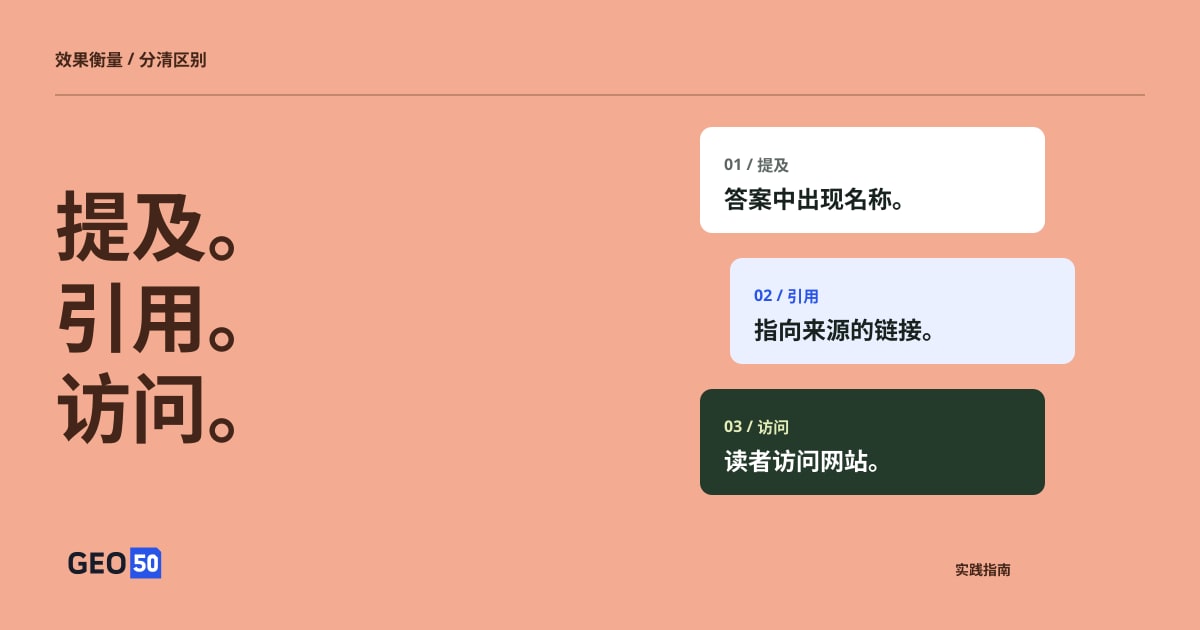
网站更新后,品牌分数提高了。最直接的反应是把这次更新视为成功。在下结论前,先看看答案究竟发生了什么:品牌出现得更频繁了,获得了更强的推荐,还是增加了官网链接?这些是不同的改善。
有用的衡量始于具体问题,例如“在相关客户需求下,AI 答案是否推荐我们的产品?”这个问题决定应采集哪些提问、统计什么事件,以及怎样的比较有意义。2026 年批判性综述明确建议:采集数据前,先定义目标结果、分母,以及具有实际意义的差异。
分开理解出现、偏好与引用
答案说“Acme 是几款日程工具之一”,可以确认一次提及;“Acme 适合这家代理机构”,增加了一次推荐;“按这些需求,Acme 是我的首选”,则表达了更强的偏好。来源链接是另一种事件,可能指向公司官网、独立评测,或竞争对手。
| 事件 | 证据需要显示什么 |
|---|---|
| 提及 | 答案中说出了品牌名称 |
| 推荐 | 答案将品牌作为合适的选择提出 |
| 首选 | 答案明确表达优先选择该品牌 |
| 官网引用 | 链接指向公司自己的页面 |
这也解释了为什么不能只看标题就比较研究成果。C-SEO Bench衡量的是引用顺序变化,与品牌被提及或明确推荐的频率不同。使用自动化报告时,应抽样核对原始回答,确认标签符合实际语义。URL 中包含品牌名,或产品位于列表第一项,都不足以证明答案明确将其列为首选。
检查引用究竟支持了什么
链接让答案可以被检查,却不能证明页面支持了对应主张。在 2023 年的生成式搜索研究中,Liu、Zhang 和 Liang 审计了 Bing Chat、NeevaAI、Perplexity 与 YouChat。在所评估系统中,平均 51.5% 的生成表述得到引用的完整支持,74.5% 的引用支持其对应表述。这些是历史审计结果,不是对今天平台准确率的估计。
两个数字回答不同的问题。引用召回率关注需要核查的表述是否获得完整来源支持;引用精确率关注所附引用是否支持答案所说的内容。两者都需要检查来源,不能通过数链接来判断。
假设答案说一款产品支持离线使用,并包含免费入门培训。确认离线功能的页面只支持了其中一部分。在认为答案准确之前,还需要核查另一个主张、适用套餐与日期。即使来源完整支持表述,也是在检验归因,并不证明来源本身正确。对企业而言,实际要检查的是自己的能力与限制是否在转述中得到保留。
让分母清楚可见
假设 20 次采集尝试得到 16 份可用回答,其中 4 份引用了公司官网。可用回答中的引用率为 4/16,即 25%;采集成功率为 16/20,即 80%。这组假设数字描述的是两件事。如果只报告“25% 可见度”,就掩盖了采集失败,也没有说清统计的事件。
完整回答中没有品牌,与请求失败也不同。前者是观察到没有出现,后者是缺少证据。应分开记录,并说明哪些观察进入各项指标。
问题选择同样重要。“Acme 是一款好的日程工具吗?”是在观察对指定品牌的回应;“哪些工具适合小型代理机构?”是在观察品类中的自然发现。如果不加区分地混合,仅仅换一批问题就可能改变分数。生成的问题属于测试集,并不衡量真实客户提问的频率。
接受答案之间会有波动
2026 年预印本《不要只测一次》通过跨时间观察与重复采样,研究了四个 AI 搜索引擎。在其 24 小时内的来源分析中,四类业务主题的平均 Jaccard 重合度约为 32%–43%。Jaccard 重合度比较两组来源的交集与并集,不是品牌提及率,也不是答案正确的概率。
这部分分析对每个“引擎—提示词”最多重复十次,并从来源比较中排除了没有提取到引用的运行。采集环境位于瑞士,选定领域和品牌识别规则也限制了结论的推广范围。它提供的有用发现是:即使没有间隔很长时间,也没有修改网站,第二次回答仍可能与第一次明显不同。
因此,需要分别做三种检查:重复完全相同的问题,观察运行波动;使用含义相同的不同问法,观察措辞敏感性;跨时间重复固定问题集,观察变化。能经受这三种检查的结果,比一张有利截图提供更多信息。
GEO50 如何把品牌信号汇总成分数
GEO50 汇总采样所得单轮 AI 回答中已确认的品牌信号。当前公式是我们的评分规则,并非本文所引论文规定的公式。网站引用、引荐访问与引用质量不计入此分数。
| 信号 | 分数贡献 |
|---|---|
| 品牌出现在回答中 | 20 × 提及率 |
| 品牌获得明确推荐 | 50 × 明确推荐率 |
| 品牌被明确列为首选 | 30 × 明确首选率 |
| 品牌被明确表示不推荐 | −50 × 明确不推荐率 |
各项比率取 0 到 1 之间的值,相加后将结果限制在 0–100 分。首选是推荐的子集,会获得额外权重。列表顺序、加粗或重复出现本身不能证明首选;同一回答包含一个品牌的多个产品,也不会重复加分。
以十份等权回答为假设:某品牌在全部十份中都只被中性提及,得分为 20。另一个品牌在三份中被推荐,其余七份未出现,且从未被列为首选,得分为 21:20 × 0.3 + 50 × 0.3。差异体现了规则对推荐的重视,这两个数字都不是购买概率。
重复样本先在每个“问题—平台”组合内取平均,再对各组合等权汇总。未提到任何品牌的完整回答仍保留在分母中。只有全部计划样本均有效,并完成兼容方法的分析后,才展示分数和名次。不完整采集不会被记为零分,前文 4/16 的引用例子也不代表可以据此生成 GEO50 排名。
含糊或相互矛盾的推荐保留为不确定判断,不会被假定为正面或负面信号。因此,分数汇总的是本规则下已确认的信号,不是置信水平、市场份额估计或产品质量评分。

GEO50 当前评分规则,已与实现核对。明确首选在推荐基础上获得额外权重;模糊信号保留不确定判断。这不是引用论文规定的评分公式。 查看原图。
在相同条件下比较观察
只有比较条件一致,分数的高低才有解释价值。综述提出的研究方案结合了重复测量、同义问法、对照与人工核查。它还指出,回答会按问题、来源和日期形成聚类;把每份输出都当成独立的客户偏好,可能低估不确定性。Martinez
企业报告可以保留一份简洁的比较记录:
| 维度 | 应保留的信息 |
|---|---|
| 问题 | 完整措辞、客户意图与选取方法 |
| 条件 | 平台、产品界面、语言、目标市场和时间 |
| 样本 | 各问题与平台的计划数、可用数与失败数 |
| 修改 | 页面版本、修改日期,以及可行时保留的未修改对照 |
| 证据 | 原始回答、来源 URL 与自动判断的核查记录 |
先用小规模试测了解波动,再根据决策需要选择采样深度。如果不改善问题覆盖与采集一致性,只增加数量,仍可能得到误导性结果。GEO50 当前的排名不展示统计置信区间,也不证明某次修改的因果效果。
用排名决定下一步调查什么
在相关客户需求下表现较弱,可以提示我们检查缺失的产品事实、模糊的定位,或更有说服力的竞争答案;表现较强,则可能帮助识别值得持续维护的解释。决定采取什么行动前,应查看实际回答,并结合问题集与评分方法比较观察。
把业务情境与技术上已验证的条件分开。选择某个市场,是在表达目标购买情境,本身并不复现当地用户环境。Google 的 AI 功能流量包含在 Search Console 的整体网页搜索报告中,因此该总量不是独立的 AI 引用次数。网站分析与客户咨询可以进一步补充业务结果的证据。Google 搜索中心
GEO50 展示观察范围与采集完整度,目前下载内容是已完成的榜单,并不包含完整回答档案。可以用它定位值得检查的模式,再沿着证据深入答案与客户体验。网站准备指南说明了如何把一个发现转化为明确的内容改进。
参考来源与编辑说明
- Google 搜索中心 — AI 功能与你的网站 ↗
Google AI Overviews 与 AI Mode 的官方指导;2026 年 10 月 18 日核对。属于平台要求,不是实验研究。
- Schulte、Bleeker 与 Kaufmann — Don’t Measure Once: Measuring Visibility in AI Search (GEO) ↗
2026 年预印本,arXiv v1,4 月 8 日。第 3–6 节:四个引擎的跨时间与重复采样,以及来源/品牌重合度。瑞士采集环境、选定业务领域、子串匹配的品牌识别和筛选规则限制了推广范围。
- Liu、Zhang 与 Liang — Evaluating Verifiability in Generative Search Engines ↗
Findings of EMNLP 2023;arXiv v2,2023 年 10 月 23 日。第 2.3–2.4 节、第 4.2 节及局限部分:引用召回率、引用精确率,以及来源支持与事实真实性的区别。属于历史审计,不是当前平台评分。
- Martinez — Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026) ↗
2026 年综述预印本,arXiv v1,7 月 15 日。综合 45 项研究;第 3、6、11 节区分处理阶段、可见度结果和测量设计。用于理解研究脉络,不作为独立实验验证。
- Puerto 等 — C-SEO Bench: Does Conversational SEO Work? ↗
NeurIPS 2025,数据集与基准测试赛道。第 4 节及第 6–7 节:两类任务、六个领域、引用排序和竞争性采用。采用英语基准;上下文顺序实验不证明如何在真实引擎中获得该顺序。