Puntuaciones GEO explicadas: qué puede decirte la cifra
Comprende qué cuenta una puntuación de visibilidad, su estabilidad y cómo ayuda la investigación a distinguir un ranking observado de una conclusión empresarial fiable.

Actualizado
Interpreta una puntuación GEO comprobando el evento que cuenta, las preguntas y muestras que la sustentan y cuánto varían las respuestas. Las menciones, recomendaciones, citas y visitas describen resultados distintos. GEO50 combina señales de marca confirmadas en un ranking para una observación definida; interpretar un cambio también requiere condiciones comparables y las pruebas subyacentes.
Ideas clave
- Identifica el evento y el denominador antes de comparar puntuaciones.
- Usa respuestas repetidas y comprobaciones de fuentes para evaluar la fiabilidad.
- Trata el ranking como prueba para una decisión, no como medida de calidad del producto ni efecto demostrado de una edición.
Empieza por la decisión que debe apoyar la puntuación
La puntuación de una marca sube después de actualizar su sitio web. La tentación inmediata es declarar exitosa la actualización. Antes de hacerlo, pregunta qué cambió en las respuestas subyacentes: ¿apareció la marca más veces, recibió recomendaciones más firmes o ganó enlaces a su sitio? Son mejoras distintas.
Una medición útil empieza por una pregunta como «¿Las respuestas de IA relevantes recomiendan nuestro producto para esta necesidad del cliente?». La pregunta determina qué consultas recoger, qué evento contar y qué comparación importaría. La revisión crítica de 2026 lo hace explícito: define el resultado deseado, el denominador y la diferencia significativa antes de recopilar datos.
Separa presencia, preferencia y cita
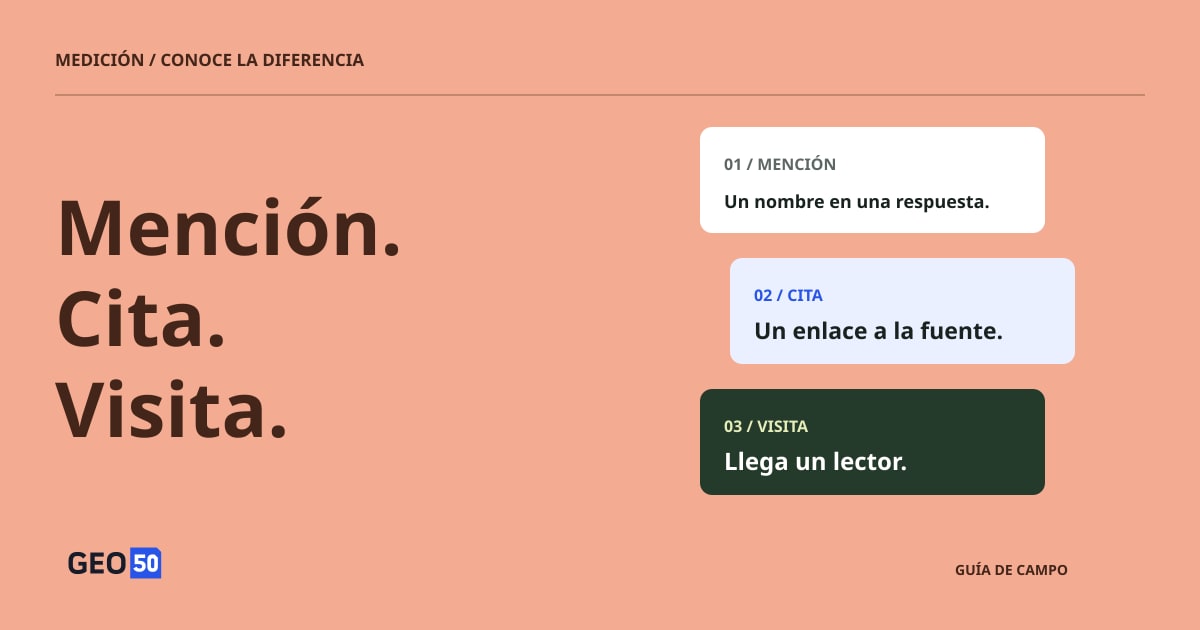
Una respuesta que dice «Acme es una de varias herramientas de programación de citas» constituye una mención. «Acme es una opción adecuada para esta agencia» añade una recomendación. «Acme es mi primera opción para estos requisitos» expresa una preferencia más fuerte. Un enlace a una fuente es un evento distinto y puede apuntar a la empresa, una reseña independiente o un competidor.
| Evento | Qué deben mostrar las pruebas |
|---|---|
| Mención | La respuesta nombra la marca |
| Recomendación | La respuesta propone la marca como una opción adecuada |
| Primera opción | La respuesta la identifica expresamente como la mejor opción |
| Cita del sitio web | Un enlace apunta a una página propia de la empresa |
Esta distinción también explica por qué no pueden compararse resultados de investigación solo por el titular. C-SEO Bench evalúa cambios en el orden de las citas; ese resultado es distinto de la frecuencia con que se nombra o recomienda expresamente una marca. En un informe automatizado, revisa una muestra de respuestas originales para comprobar que las etiquetas coinciden con el lenguaje. Un nombre de marca en una URL o un producto que aparece primero en una lista no son prueba suficiente de una recomendación explícita como primera opción.
Comprueba qué respalda realmente una cita
Un enlace permite inspeccionar una respuesta, pero no demuestra que la página enlazada respalde la afirmación. En su estudio de 2023 sobre motores de búsqueda generativos, Liu, Zhang y Liang auditaron Bing Chat, NeevaAI, Perplexity y YouChat. En los sistemas evaluados, el 51.5% de las afirmaciones generadas estaba plenamente respaldado por citas, mientras que el 74.5% de las citas respaldaba sus afirmaciones asociadas. Son resultados de una auditoría histórica, no estimaciones de la precisión actual de las plataformas.
Las dos cifras abordan preguntas diferentes. La exhaustividad de las citas se refiere a si las afirmaciones que requieren verificación tienen respaldo completo de fuentes. La precisión de las citas se refiere a si las citas adjuntas respaldan lo que dice la respuesta. Ambas requieren examinar las fuentes, en vez de contar enlaces.
Supongamos que una respuesta dice que un producto funciona sin conexión e incluye incorporación gratuita. Una página que confirma el uso sin conexión solo respalda parte de esa frase. Comprueba la otra afirmación, el plan aplicable y la fecha antes de considerar precisa la respuesta. Incluso el respaldo completo de fuentes es una prueba de atribución, no una demostración de que la propia fuente sea verdadera. Para una empresa, la revisión práctica consiste en comprobar si sus capacidades y condiciones se conservan al volver a contarlas.
Haz visible el denominador
Imagina que 20 intentos de recogida producen 16 respuestas utilizables, cuatro de las cuales citan el sitio web de la empresa. La tasa de citas entre respuestas utilizables es 4/16, o 25%; el éxito de recogida es 16/20, u 80%. Estas cifras hipotéticas describen dos cosas distintas. Informar solo de «25% de visibilidad» oculta los fallos de recogida y deja el evento sin definir.
Una respuesta completada sin mención de marca también es distinta de una solicitud fallida. La primera es una ausencia observada; la segunda es falta de pruebas. Regístralas por separado e indica qué observaciones entran en cada métrica.
La selección de preguntas importa tanto como lo anterior. «¿Es Acme una buena herramienta de programación de citas?» prueba una respuesta a una marca identificada. «¿Qué herramientas son adecuadas para una agencia pequeña?» prueba el descubrimiento dentro de una categoría. Mezclarlas sin distinguirlas puede cambiar la puntuación simplemente cambiando las preguntas. Las preguntas generadas forman un conjunto de prueba; no miden con qué frecuencia los clientes reales hacen cada pregunta.
Espera variación entre respuestas
Don’t Measure Once, una prepublicación de 2026, examinó cuatro motores de búsqueda con IA mediante observaciones a lo largo del tiempo y ejecuciones repetidas. En su análisis de fuentes dentro de 24 horas, la coincidencia media de Jaccard osciló aproximadamente entre el 32% y el 43% en las cuatro categorías de campañas. La coincidencia de Jaccard compara las fuentes compartidas con la unión de los dos conjuntos de fuentes; no es la tasa de mención de una marca ni la probabilidad de que una respuesta sea correcta.
El análisis utilizó hasta diez repeticiones por combinación de motor y consulta, y excluyó de esa comparación de fuentes las ejecuciones sin citas extraídas. El contexto de recogida fue suizo, y los sectores seleccionados y las reglas de detección de marcas limitan aún más la generalización. Su hallazgo útil es que una segunda respuesta puede diferir sustancialmente incluso sin un largo intervalo ni una edición del sitio.
Esto sugiere tres comprobaciones distintas: repetir la misma pregunta para examinar la variación entre ejecuciones, usar formulaciones equivalentes para examinar la sensibilidad a la redacción y repetir un conjunto fijo de preguntas a lo largo del tiempo para examinar cambios. Un resultado que supera las tres es más informativo que una captura favorable.
Cómo convierte GEO50 las señales de marca en una puntuación
GEO50 resume señales de marca confirmadas en respuestas de IA muestreadas de un solo turno. Su fórmula actual es nuestra política de puntuación, no una fórmula prescrita por los artículos aquí citados. Las citas web, visitas de referencia y calidad de citas quedan fuera de esta puntuación.
| Señal | Contribución |
|---|---|
| La marca aparece en la respuesta | 20 × tasa de mención |
| La marca se recomienda expresamente | 50 × tasa de recomendación |
| La marca es expresamente la primera opción | 30 × tasa de primera opción |
| La marca se desaconseja expresamente | −50 × tasa de no recomendación |
Usa tasas entre 0 y 1, suma las contribuciones y limita el resultado a 0–100. La primera opción es un subconjunto de la recomendación y recibe un peso adicional. El orden de lista, la negrita o la repetición por sí solos no establecen una primera opción, y varios productos de una misma marca en una respuesta no aportan puntos extra.
En diez respuestas hipotéticas con igual peso, una marca mencionada de forma neutra en las diez obtiene 20. Una marca recomendada en tres, ausente en siete y nunca identificada como primera opción obtiene 21: 20 × 0.3 + 50 × 0.3. La diferencia refleja el énfasis de la política de puntuación en la recomendación; ninguna cifra es una probabilidad de compra.
Las muestras repetidas se promedian dentro de cada combinación de pregunta y plataforma, y esas combinaciones reciben igual peso. Una respuesta completa que no nombra marcas permanece en el denominador. Todas las muestras previstas deben ser válidas y estar analizadas con un método compatible antes de mostrar puntuaciones y posiciones. A una recogida incompleta no se le asigna cero, y el ejemplo anterior de citas 4/16 no cumple los requisitos de una observación para un ranking de GEO50.
Las recomendaciones ambiguas o contradictorias conservan un juicio incierto, en vez de asumir una señal positiva o negativa. Por tanto, la puntuación resume señales confirmadas bajo esta política. No es un nivel de confianza, una estimación de cuota de mercado ni una valoración de calidad del producto.

Política actual de puntuación de GEO50, contrastada con la implementación. La primera opción añade peso a una recomendación; las señales ambiguas siguen siendo inciertas. No es una fórmula prescrita por los artículos citados. Ver el diagrama a tamaño completo.
Compara observaciones en las mismas condiciones
Una puntuación más alta resulta informativa cuando la comparación conserva el significado de la medición. El protocolo de investigación propuesto en la revisión combina mediciones repetidas, paráfrasis, controles y validación humana. También señala que las respuestas se agrupan por preguntas, fuentes y fechas: tratar cada salida como una preferencia independiente del cliente puede subestimar la incertidumbre. Martinez
Para un informe empresarial, mantén un registro compacto de comparación:
| Dimensión | Qué mantener visible |
|---|---|
| Preguntas | Redacción exacta, intención del cliente y método de selección |
| Condiciones | Plataforma, interfaz del producto, idioma, mercado previsto y momento |
| Muestras | Observaciones previstas, utilizables y fallidas para cada pregunta y plataforma |
| Cambio | Versiones de página, fecha de intervención y una comparación sin intervención cuando sea viable |
| Pruebas | Respuestas originales, URL de fuentes y comprobaciones de juicios automatizados |
Usa un piloto para evaluar la variabilidad y elegir la profundidad de muestreo para la decisión. Aumentar el número sin mejorar la cobertura de preguntas o la coherencia de recogida puede seguir produciendo un resultado engañoso. El ranking actual de GEO50 no muestra intervalos de confianza estadísticos ni establece el efecto causal de una edición.
Usa el ranking para decidir qué investigar
Un resultado débil para una necesidad relevante del cliente puede dirigir la atención a datos de producto ausentes, un posicionamiento poco claro o respuestas competidoras más sólidas. Un resultado mejor puede identificar una explicación que merece mantenerse. Revisa las respuestas reales antes de decidir la siguiente acción y compara observaciones teniendo presentes su conjunto de preguntas y método de puntuación.
Mantén el contexto empresarial separado de lo verificado técnicamente. Seleccionar un mercado expresa el contexto de compra previsto; no reproduce por sí solo el entorno de un usuario local. El tráfico de las funciones de IA de Google se incluye en los informes generales de Web en Search Console, por lo que ese total no es un recuento independiente de citas de IA. La analítica web y las consultas de clientes aportan más pruebas sobre resultados empresariales. Google Search Central
GEO50 muestra el alcance de la observación y la integridad de la recogida, y su descarga actual contiene el ranking completo, no el archivo íntegro de respuestas. Úsalo para localizar patrones que merezcan examinarse y después sigue las pruebas en las respuestas y la experiencia del cliente. Nuestra guía para preparar el sitio web explica cómo convertir un hallazgo en una mejora definida del contenido.
Fuentes y nota editorial
- Google Search Central — Funciones de IA y tu sitio web ↗
Orientación oficial para Google AI Overviews y AI Mode; consultada el 18 de octubre de 2026. Requisitos de plataforma, no un estudio experimental.
- Schulte, Bleeker y Kaufmann — No midas una sola vez: medir la visibilidad en búsqueda con IA (GEO) ↗
Prepublicación de 2026, arXiv v1, 8 de abril. Secciones 3–6: coincidencia longitudinal y entre ejecuciones repetidas de fuentes y marcas en cuatro motores. El contexto suizo de recogida, los sectores de campaña seleccionados, la detección de marcas por subcadenas y el filtrado limitan la generalización.
- Liu, Zhang y Liang — Evaluación de la verificabilidad en motores de búsqueda generativos ↗
Findings of EMNLP 2023; arXiv v2, 23 de octubre de 2023. Secciones 2.3–2.4 y 4.2, además de Limitaciones: exhaustividad y precisión de las citas y diferencia entre respaldo de fuentes y verdad factual. Auditoría histórica, no una evaluación actual de plataformas.
- Martinez — Optimizar la visibilidad en motores generativos: revisión crítica de la optimización para motores generativos (2023–2026) ↗
Prepublicación de revisión de 2026, arXiv v1, 15 de julio. Síntesis de 45 estudios; las secciones 3, 6 y 11 distinguen etapas del proceso, resultados de visibilidad y diseño de medición. Debe utilizarse como síntesis de investigación, no como confirmación experimental independiente.
- Puerto et al. — C-SEO Bench: ¿funciona el SEO conversacional? ↗
NeurIPS 2025, sección Datasets and Benchmarks. Secciones 4 y 6–7: dos tareas, seis dominios, orden de citas y adopción por competidores. Evaluación comparativa en inglés; los experimentos sobre el orden del contexto no demuestran cómo obtener ese orden en un motor real.