GEO-Punktwerte erklärt: Was die Zahl aussagen kann
Verstehen Sie, was ein Sichtbarkeitswert zählt, wie stabil er ist und wie Forschung ein beobachtetes Ranking von einer belastbaren Geschäftsaussage unterscheidet.

Aktualisiert
Prüfen Sie bei einem GEO-Punktwert das gezählte Ereignis, die zugrunde liegenden Fragen und Stichproben sowie die Antwortschwankungen. Erwähnungen, Empfehlungen, Zitate und Besuche beschreiben unterschiedliche Ergebnisse. GEO50 kombiniert bestätigte Markensignale zu einem Ranking für eine definierte Beobachtung; Veränderungen erfordern zusätzlich vergleichbare Bedingungen und die zugrunde liegenden Belege.
Das Wichtigste
- Identifizieren Sie Ereignis und Nenner vor einem Vergleich von Punktwerten.
- Bewerten Sie Zuverlässigkeit durch wiederholte Antworten und Quellenprüfungen.
- Betrachten Sie das Ranking als Entscheidungsbeleg, nicht als Produktqualitätsmaß oder bewiesenen Bearbeitungseffekt.
Mit der Entscheidung beginnen, die der Punktwert unterstützen soll
Der Punktwert einer Marke steigt nach einer Websiteaktualisierung. Sofort liegt die Versuchung nahe, die Änderung als erfolgreich zu bezeichnen. Fragen Sie zuvor, was sich in den zugrunde liegenden Antworten verändert hat: Wurde die Marke häufiger genannt, stärker empfohlen oder öfter auf ihre Website verlinkt? Das sind unterschiedliche Verbesserungen.
Eine nützliche Messung beginnt mit einer Frage wie „Empfehlen relevante KI-Antworten unser Produkt für diesen Kundenbedarf?“. Sie bestimmt die zu erhebenden Prompts, das gezählte Ereignis und den sinnvollen Vergleich. Die kritische Übersicht von 2026 macht dies ausdrücklich: Gewünschtes Ergebnis, Nenner und bedeutsame Differenz vor der Datenerhebung definieren.
Präsenz von Präferenz und Zitierung trennen
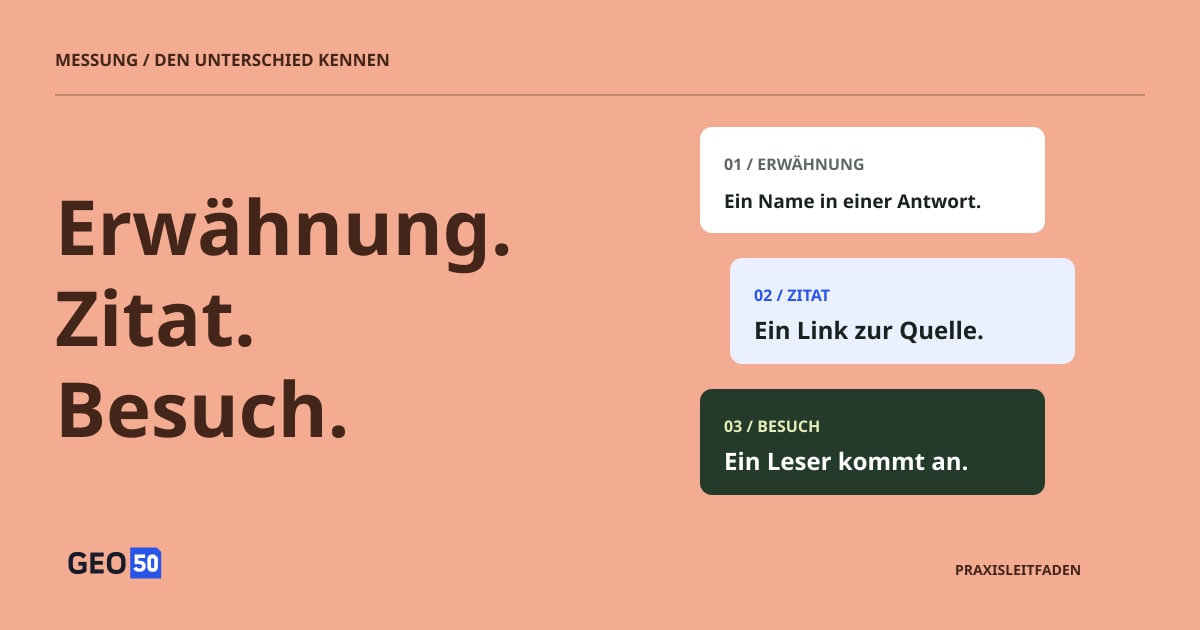
Die Aussage „Acme ist eines von mehreren Terminplanungstools“ ist eine Erwähnung. „Acme eignet sich für diese Agentur“ fügt eine Empfehlung hinzu. „Acme ist für diese Anforderungen meine erste Wahl“ drückt eine stärkere Präferenz aus. Ein Quellenlink ist ein eigenständiges Ereignis und kann auf das Unternehmen, eine unabhängige Bewertung oder einen Wettbewerber zeigen.
| Ereignis | Was die Belege zeigen müssen |
|---|---|
| Erwähnung | Die Marke wird in der Antwort genannt |
| Empfehlung | Die Antwort schlägt die Marke als geeignete Wahl vor |
| Erste Wahl | Die Antwort bezeichnet sie ausdrücklich als beste Wahl |
| Websitezitat | Ein Link führt auf eine eigene Unternehmensseite |
Diese Unterscheidung erklärt auch, warum sich Forschungsergebnisse nicht anhand der Überschrift vergleichen lassen. C-SEO Bench bewertet Veränderungen der Zitierreihenfolge; das unterscheidet sich von der Häufigkeit einer Markennennung oder ausdrücklichen Empfehlung. Prüfen Sie bei automatisierten Berichten eine Stichprobe der Originalantworten, damit die Kennzeichnungen zum Wortlaut passen. Ein Markenname in einer URL oder ein Produkt an erster Listenposition belegt keine ausdrückliche Empfehlung als erste Wahl.
Prüfen, was ein Zitat tatsächlich belegt
Ein Link macht eine Antwort überprüfbar, belegt aber nicht, dass die verlinkte Seite die Aussage stützt. In ihrer Studie zu generativen Suchsystemen von 2023 untersuchten Liu, Zhang und Liang Bing Chat, NeevaAI, Perplexity und YouChat. Über die untersuchten Systeme hinweg waren 51.5% der erzeugten Aussagen vollständig durch Zitate gestützt, während 74.5% der Zitate ihre zugehörigen Aussagen stützten. Dies sind historische Audit-Ergebnisse, keine Schätzungen zur heutigen Plattformgenauigkeit.
Die beiden Zahlen beantworten unterschiedliche Fragen. Zitierungs-Recall betrifft die vollständige Quellenstützung prüfungsbedürftiger Aussagen. Zitierungspräzision betrifft die Frage, ob angefügte Zitate den Antwortinhalt stützen. Beide erfordern Quellenprüfung statt bloßes Linkzählen.
Angenommen, eine Antwort behauptet Offlinebetrieb und kostenlose Einführung. Eine Seite, die Offlinenutzung bestätigt, belegt nur einen Teil dieses Satzes. Prüfen Sie die weitere Aussage, den geltenden Tarif und das Datum, bevor Sie die Antwort als korrekt behandeln. Selbst vollständige Quellenstützung prüft die Zuschreibung, nicht die Wahrheit der Quelle selbst. Für Unternehmen lautet die praktische Frage, ob Fähigkeiten und Bedingungen beim Nacherzählen erhalten bleiben.
Den Nenner sichtbar machen
Stellen Sie sich vor, 20 Erhebungsversuche liefern 16 nutzbare Antworten, von denen vier die Unternehmenswebsite zitieren. Die Zitierungsrate unter nutzbaren Antworten beträgt 4/16 oder 25%; der Erhebungserfolg 16/20 oder 80%. Diese hypothetischen Zahlen beschreiben unterschiedliche Dinge. Nur „25% Sichtbarkeit“ zu melden verschleiert fehlgeschlagene Erhebungen und lässt das Ereignis undefiniert.
Eine vollständige Antwort ohne Markennennung ist ebenfalls etwas anderes als eine fehlgeschlagene Anfrage. Erstere ist beobachtete Abwesenheit, Letztere fehlende Evidenz. Erfassen Sie beides getrennt und nennen Sie die Beobachtungen, die in jede Kennzahl eingehen.
Die Fragenauswahl ist ebenso wichtig. „Ist Acme ein gutes Terminplanungstool?“ testet eine Reaktion auf eine benannte Marke. „Welche Tools passen zu einer kleinen Agentur?“ testet Entdeckung innerhalb einer Kategorie. Unterscheidungsloses Mischen kann den Punktwert allein durch andere Fragen verändern. Generierte Fragen bilden einen Testsatz; sie messen nicht, wie häufig echte Kunden die jeweilige Frage stellen.
Mit Schwankungen zwischen Antworten rechnen
Don’t Measure Once, ein Preprint von 2026, untersuchte vier KI-Suchsysteme mit zeitlichen Beobachtungen und wiederholten Durchläufen. Bei der Quellenanalyse innerhalb von 24 Stunden lag die durchschnittliche Jaccard-Überschneidung in den vier Kampagnenkategorien bei ungefähr 32% bis 43%. Jaccard vergleicht gemeinsame Quellen mit der Vereinigungsmenge beider Quellensätze; das ist weder eine Markenerwähnungsrate noch eine Wahrscheinlichkeit für die Richtigkeit einer Antwort.
Die Analyse nutzte bis zu zehn Wiederholungen pro System–Prompt und schloss Durchläufe ohne extrahierte Zitate aus diesem Quellenvergleich aus. Die Erhebung erfolgte im Schweizer Kontext; ausgewählte Branchen und Regeln zur Markenerkennung begrenzen die Übertragbarkeit zusätzlich. Die nützliche Erkenntnis lautet, dass eine zweite Antwort auch ohne großen Zeitabstand oder Websiteänderung deutlich abweichen kann.
Daraus ergeben sich drei getrennte Prüfungen: identische Fragen wiederholen, um Durchlaufschwankungen zu untersuchen; gleichwertige Formulierungen nutzen, um Wortlautsensitivität zu prüfen; und einen festen Fragensatz über die Zeit wiederholen, um Änderungen zu beobachten. Ein Ergebnis, das alle drei übersteht, ist aussagekräftiger als ein günstiger Screenshot.
Wie GEO50 Markensignale in einen Punktwert übersetzt
GEO50 fasst bestätigte Markensignale in erhobenen KI-Antworten mit jeweils einem Gesprächsschritt zusammen. Die aktuelle Formel ist unsere Bewertungsregel, keine von den hier zitierten Arbeiten vorgegebene Formel. Websitezitate, Verweisbesuche und Zitierungsqualität liegen außerhalb dieses Punktwerts.
| Signal | Beitrag |
|---|---|
| Marke erscheint in der Antwort | 20 × Erwähnungsrate |
| Marke wird ausdrücklich empfohlen | 50 × Empfehlungsrate |
| Marke ist ausdrücklich erste Wahl | 30 × Erste-Wahl-Rate |
| Von der Marke wird ausdrücklich abgeraten | −50 × Nichtempfehlungsrate |
Verwenden Sie Raten von 0 bis 1, addieren Sie die Beiträge und begrenzen Sie das Ergebnis auf 0–100. Erste Wahl ist eine Teilmenge der Empfehlung und erhält zusätzliches Gewicht. Listenreihenfolge, Fettdruck oder Wiederholung allein begründen keine erste Wahl; mehrere Produkte derselben Marke in einer Antwort bringen keine Zusatzpunkte.
Bei zehn hypothetischen, gleich gewichteten Antworten erhält eine überall neutral erwähnte Marke 20 Punkte. Eine in drei Antworten empfohlene, in sieben fehlende und nie als erste Wahl benannte Marke erhält 21: 20 × 0.3 + 50 × 0.3. Der Unterschied spiegelt die Betonung der Empfehlung in der Bewertungsregel wider; keine Zahl ist eine Kaufwahrscheinlichkeit.
Wiederholte Stichproben werden innerhalb jeder Frage–Plattform-Kombination gemittelt; diese Kombinationen erhalten gleiches Gewicht. Eine vollständige Antwort ohne Marken bleibt im Nenner. Sämtliche geplanten Stichproben müssen gültig und mit kompatibler Methode analysiert sein, bevor Punkte und Ränge erscheinen. Unvollständige Erhebung erhält nicht null Punkte, und das frühere Zitierungsbeispiel 4/16 qualifiziert eine Beobachtung nicht für ein GEO50-Ranking.
Mehrdeutige oder widersprüchliche Empfehlungen behalten ein unsicheres Urteil statt eines unterstellten positiven oder negativen Signals. Der Punktwert fasst somit bestätigte Signale nach dieser Regel zusammen. Er ist weder Konfidenzniveau noch Marktanteilsschätzung oder Produktqualitätsbewertung.

Die aktuelle GEO50-Bewertungsregel, anhand der Implementierung geprüft. Erste Wahl gibt einer Empfehlung zusätzliches Gewicht; mehrdeutige Signale bleiben unsicher. Die Formel wird nicht von den zitierten Arbeiten vorgeschrieben. Diagramm in voller Größe ansehen.
Beobachtungen zu gleichen Bedingungen vergleichen
Ein höherer Punktwert wird informativ, wenn der Vergleich die Bedeutung der Messung bewahrt. Das vorgeschlagene Forschungsprotokoll der Übersicht verbindet wiederholte Messungen, Umformulierungen, Kontrollen und menschliche Validierung. Es weist außerdem darauf hin, dass Antworten nach Fragen, Quellen und Daten gruppiert sind: Jede Ausgabe als unabhängige Kundenpräferenz zu behandeln kann Unsicherheit unterschätzen. Martinez
Führen Sie für einen Geschäftsbericht ein kompaktes Vergleichsprotokoll:
| Dimension | Sichtbar halten |
|---|---|
| Fragen | Exakter Wortlaut, Kundenabsicht und Auswahlmethode |
| Bedingungen | Plattform, Produktoberfläche, Sprache, Zielmarkt und Zeitpunkt |
| Stichproben | Geplante, nutzbare und fehlgeschlagene Beobachtungen je Frage und Plattform |
| Änderung | Seitenversionen, Eingriffsdatum und nach Möglichkeit unbehandelte Vergleichsgruppe |
| Belege | Originalantworten, Quellen-URLs und Prüfungen automatisierter Urteile |
Nutzen Sie einen Pilotversuch, um Schwankungen einzuschätzen und die Stichprobentiefe für die Entscheidung zu wählen. Mehr Antworten ohne bessere Frageabdeckung oder konsistente Erhebung können weiterhin irreführende Ergebnisse liefern. Das aktuelle GEO50-Ranking zeigt keine statistischen Konfidenzintervalle und belegt keinen kausalen Effekt einer Bearbeitung.
Mit dem Ranking den Untersuchungsbedarf bestimmen
Ein schwaches Ergebnis für einen relevanten Kundenbedarf kann auf fehlende Produktfakten, unklare Positionierung oder stärkere Wettbewerberantworten hinweisen. Ein stärkeres Ergebnis kann eine bewahrenswerte Erklärung zeigen. Prüfen Sie die tatsächlichen Antworten vor der nächsten Maßnahme und vergleichen Sie Beobachtungen mit Blick auf Fragensatz und Bewertungsmethode.
Trennen Sie Geschäftskontext von technisch Verifiziertem. Die Auswahl eines Marktes beschreibt den vorgesehenen Kaufkontext; sie reproduziert nicht automatisch die Umgebung eines lokalen Nutzers. Der Traffic aus Googles KI-Funktionen ist in den gesamten Web-Berichten der Search Console enthalten und daher keine separate Zählung von KI-Zitaten. Websiteanalyse und Kundenanfragen liefern weitere Belege für Geschäftsergebnisse. Google Search Central
GEO50 zeigt Beobachtungsumfang und Vollständigkeit der Erhebung; der aktuelle Download enthält das vollständige Ranking, nicht das gesamte Antwortarchiv. Nutzen Sie ihn, um untersuchenswerte Muster zu finden, und verfolgen Sie anschließend die Belege in Antworten und Kundenerfahrung. Unser Leitfaden zur Websitevorbereitung erklärt, wie eine Erkenntnis zu einer klar definierten Inhaltsverbesserung wird.
Quellen und redaktioneller Hinweis
- Google Search Central — KI-Funktionen und Ihre Website ↗
Offizielle Hinweise für Google AI Overviews und AI Mode; geprüft am 18. Oktober 2026. Plattformanforderungen, keine experimentelle Studie.
- Schulte, Bleeker und Kaufmann — Nicht nur einmal messen: Sichtbarkeit in KI-Suche messen (GEO) ↗
Preprint von 2026, arXiv v1, 8. April. Abschnitte 3–6: zeitliche und wiederholte Quellen-/Markenüberschneidung über vier Systeme. Schweizer Erhebungskontext, ausgewählte Kampagnenbranchen, teilzeichenfolgenbasierte Markenerkennung und Filterung begrenzen die Übertragbarkeit.
- Liu, Zhang und Liang — Verifizierbarkeit in generativen Suchsystemen bewerten ↗
Findings of EMNLP 2023; arXiv v2, 23. Oktober 2023. Abschnitte 2.3–2.4 und 4.2 sowie Grenzen: Vollständigkeit und Präzision von Zitaten und der Unterschied zwischen Quellenstützung und sachlicher Wahrheit. Historisches Audit, keine aktuelle Plattformbewertung.
- Martinez — Sichtbarkeit in generativen Systemen optimieren: Eine kritische Übersicht zu Generative Engine Optimization (2023–2026) ↗
Übersichts-Preprint von 2026, arXiv v1, 15. Juli. Synthese von 45 Studien; Abschnitte 3, 6 und 11 unterscheiden Prozessstufen, Sichtbarkeitsergebnisse und Messdesign. Als Forschungssynthese nutzen, nicht als unabhängige experimentelle Bestätigung.
- Puerto et al. — C-SEO Bench: Funktioniert konversationelles SEO? ↗
NeurIPS 2025, Bereich Datasets and Benchmarks. Abschnitte 4 und 6–7: zwei Aufgaben, sechs Bereiche, Zitierungsrang und konkurrierende Anwender. Englischsprachiger Benchmark; Experimente zur Kontextreihenfolge zeigen nicht, wie diese Reihenfolge in einem realen Suchsystem erreicht wird.