Baca versi asal bahasa Inggeris ↗
Memahami skor GEO: apa yang boleh dijelaskan angkanya
Fahami apa yang dikira skor keterlihatan, kestabilannya, dan bagaimana penyelidikan membantu membezakan kedudukan diperhatikan dari kesimpulan perniagaan yang boleh dipercayai.

Dikemas kini
Baca skor GEO dengan memeriksa peristiwa yang dikira, soalan dan sampel di baliknya, serta variasi jawapan. Sebutan, saranan, sitasi, dan kunjungan menggambarkan hasil berbeza. GEO50 menggabungkan isyarat jenama disahkan menjadi kedudukan untuk pemerhatian ditakrifkan; mentafsirkan perubahan juga memerlukan keadaan sebanding dan bukti yang mendasarinya.
Perkara yang perlu diingat
- Pengenalpastian peristiwa dan penyebut sebelum membandingkan skor.
- Gunakan jawapan berulang dan pemeriksaan sumber untuk menilai kebolehpercayaan.
- Perlakukan kedudukan sebagai bukti untuk mengambil keputusan, bukan saiz kualiti produk atau kesan penyuntingan yang telah terbukti.
Mulakan dari keputusan yang perlu disokong skor
Skor jenama naik selepas kemas kini laman. Dorongan serta-merta ialah menganggap kemas kini itu berjaya. Sebelum melakukannya, tanyakan perubahan dalam jawapan yang mendasari: adakah jenama lebih kerap muncul, menerima saranan lebih kuat, atau memperoleh pautan ke lamannya? Itu adalah penambahbaikan berbeza.
Pengukuran berguna bermula dari soalan seperti “Adakah jawapan AI yang relevan menyarankan produk kita untuk keperluan pelanggan ini?” Soalan menentukan prompt yang dikumpulkan, peristiwa yang dikira, dan perbandingan yang bermakna. Tinjauan kritis 2026 menegaskan: tentukan hasil tujuan, penyebut, dan perbezaan yang bermakna sebelum mengumpulkan data.
Asingkan kehadiran dari keutamaan dan sitasi
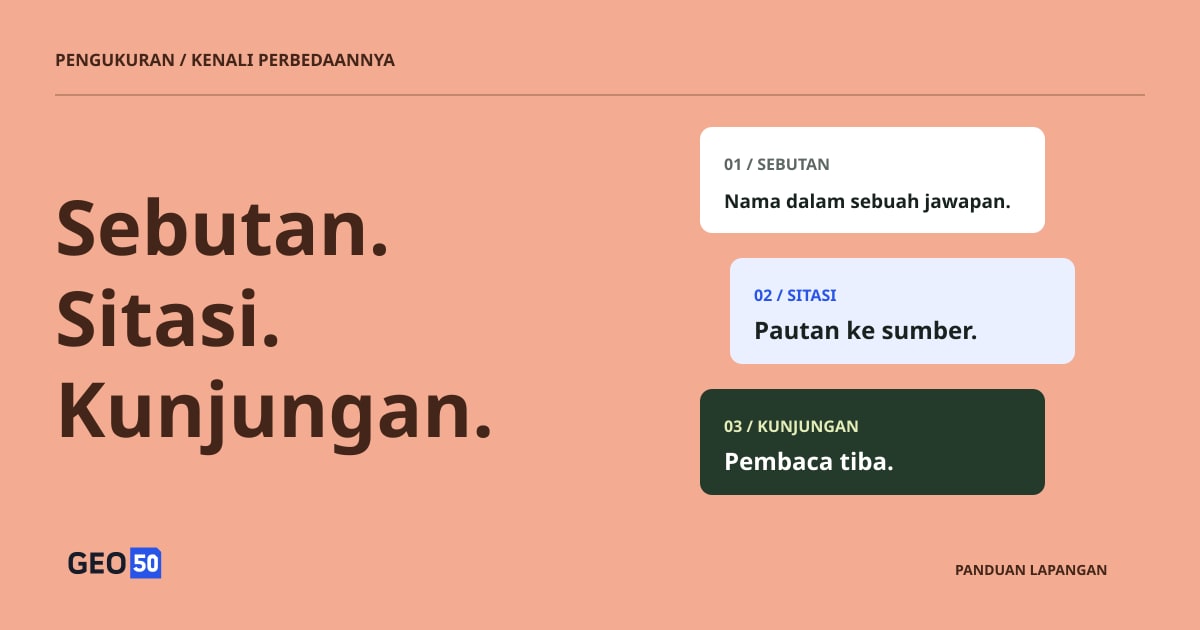
Jawapan “Acme adalah salah satu dari beberapa alat penjadualan” menunjukkan sebutan. “Acme adalah pilihan yang sesuai untuk agensi ini” menambahkan saranan. “Acme adalah pilihan pertama saya untuk keperluan ini” menunjukkan keutamaan lebih kuat. Pautan sumber adalah peristiwa berasingan dan boleh menuju syarikat, ulasan bebas, atau pesaing.
| Peristiwa | Yang perlu ditunjukkan bukti |
|---|---|
| Sebutan | Nama jenama disebut dalam jawapan |
| Saranan | Jawapan mencadangkan jenama sebagai pilihan yang sesuai |
| Pilihan pertama | Jawapan secara eksplisit menempatkannya sebagai pilihan utama |
| Sitasi laman | Pautan menuju halaman syarikat sendiri |
Perbezaan ini juga menjelaskan mengapa hasil penyelidikan tidak boleh dibandingkan dari tajuk sahaja. C-SEO Bench menilai perubahan susunan sitasi; hasil itu berbeza dari kekerapan nama jenama disebut atau disarankan secara eksplisit. Dalam laporan automatik, semak sampel jawapan asal untuk memastikan label sesuai dengan bahasanya. Nama jenama dalam URL atau produk di susunan pertama senarai tidak cukup membuktikan saranan eksplisit sebagai pilihan pertama.
Periksa apa yang benar-benar disokong sitasi
Pautan membuat jawapan boleh diperiksa, tetapi tidak membuktikan halaman berpaut menyokong dakwaan. Dalam kajian mesin carian generatif tahun 2023, Liu, Zhang, dan Liang mengaudit Bing Chat, NeevaAI, Perplexity, dan YouChat. Di seluruh sistem yang dinilai, 51.5% pernyataan yang dihasilkan disokong sepenuhnya oleh sitasi, sedangkan 74.5% sitasi menyokong pernyataan berkaitan. Ini hasil audit sejarah, bukan anggaran ketepatan platform pada masa ini.
Kedua angka menjawab soalan berbeza. Liputan sitasi membincangkan adakah pernyataan yang perlu disahkan mempunyai sokongan sumber penuh. Ketepatan sitasi membincangkan adakah sitasi dilampirkan menyokong isi jawapan. Keduanya memerlukan pemeriksaan sumber, bukan sekadar mengira pautan.
Andaikan jawapan mengatakan produk berfungsi secara luar talian dan merangkumi bimbingan permulaan percuma. Halaman yang mengesahkan penggunaan luar talian hanya menyokong sebahagian ayat. Periksa dakwaan lain, pakej yang berlaku, dan tarikh sebelum menganggap jawapan tepat. Malah sokongan sumber penuh adalah ujian atribusi, bukan bukti sumber itu sendiri benar. Bagi perniagaan, pemeriksaan praktikalnya adalah adakah keupayaan dan syarat kekal utuh semasa diceritakan kembali.
Paparkan penyebutnya
Bayangkan 20 percubaan pengumpulan menghasilkan 16 jawapan boleh digunakan, empat di antaranya memetik laman syarikat. Kadar sitasi di antara jawapan sesuai adalah 4/16, atau 25%; kejayaan pengumpulan adalah 16/20, atau 80%. Angka hipotetikal ini menggambarkan dua perkara berbeza. Melaporkan “keterlihatan 25%” sahaja menyembunyikan kegagalan pengumpulan dan membiarkan peristiwanya tidak ditakrifkan.
Jawapan selesai tanpa sebutan jenama juga berbeza dari permintaan gagal. Yang pertama adalah ketiadaan yang diperhatikan; yang kedua adalah bukti yang hilang. Catat berasingan dan jelaskan pemerhatian mana masuk ke setiap metrik.
Pemilihan soalan sama pentingnya. “Adakah Acme alat penjadualan yang baik?” menguji respons terhadap jenama yang disebut. “Alat apa yang sesuai untuk agensi kecil?” menguji penemuan dalam kategori. Mencampurkannya tanpa pembezaan boleh mengubah skor hanya kerana soalannya berubah. Soalan yang dihasilkan membentuk kumpulan ujian; tidak mengukur berapa kerap pelanggan sebenar menanyakan setiap soalan.
Harapkan variasi antara jawapan
Don’t Measure Once, pracetak 2026, memeriksa empat mesin carian AI melalui pemerhatian dari semasa ke semasa dan pengulangan. Dalam analisis sumber dalam 24 jam, purata pertindihan Jaccard berkisar sekitar 32% hingga 43% di empat kategori kempen. Pertindihan Jaccard membandingkan sumber bersama dengan gabungan dua kumpulan sumber; bukan kadar sebutan jenama atau kebarangkalian jawapan benar.
Analisis menggunakan hingga sepuluh pengulangan per pasangan mesin–prompt dan mengecualikan proses tanpa sitasi yang berjaya diekstrak dari perbandingan sumber tersebut. Konteks pengumpulan berada di Swiss, dan sektor terpilih serta peraturan pengesanan jenama semakin mengehadkan generalisasi. Dapatan bergunanya adalah jawapan kedua boleh berbeza secara ketara walaupun tanpa selang masa panjang atau penyuntingan laman.
Ini menyarankan tiga pemeriksaan berasingan: ulang soalan serupa sepenuhnya untuk memeriksa variasi antara proses, gunakan susunan setara untuk memeriksa kepekaan kata, dan ulang kumpulan soalan kekal dari semasa ke semasa untuk memeriksa perubahan. Hasil yang kekal dalam ketiganya lebih bermaklumat daripada satu tangkapan skrin yang menguntungkan.
Cara GEO50 mengubah isyarat jenama menjadi skor
GEO50 merumuskan isyarat jenama disahkan dalam sampel jawapan AI satu giliran. Formula pada masa ini adalah dasar penilaian kami, bukan formula yang ditetapkan makalah yang dipetik di sini. Sitasi laman, kunjungan rujukan, dan kualiti sitasi berada di luar skor ini.
| Isyarat | Sumbangan |
|---|---|
| Jenama muncul dalam jawapan | 20 × kadar sebutan |
| Jenama disarankan secara eksplisit | 50 × kadar saranan |
| Jenama secara eksplisit menjadi pilihan pertama | 30 × kadar pilihan pertama |
| Jenama secara eksplisit tidak disarankan | −50 × kadar tidak disarankan |
Gunakan kadar antara 0 dan 1, jumlahkan sumbangannya, lalu hadkan hasil pada 0–100. Pilihan pertama merupakan bahagian dari saranan dan menerima pemberat tambahan. Susunan senarai, teks tebal, atau pengulangan sahaja tidak membuktikan pilihan pertama; beberapa produk dari jenama sama dalam satu jawapan tidak mendapat mata tambahan.
Untuk sepuluh jawapan hipotetikal berpemberat sama, jenama yang disebut neutral pada semuanya mendapat skor 20. Jenama yang disarankan pada tiga jawapan, tidak muncul pada tujuh, dan tidak pernah menjadi pilihan pertama mendapat 21: 20 × 0.3 + 50 × 0.3. Perbezaan ini mencerminkan penekanan dasar skor pada saranan; kedua angka bukan kebarangkalian pembelian.
Sampel berulang dipuratakan dalam setiap pasangan soalan–platform, lalu pasangan-pasangan itu mendapat pemberat sama. Jawapan lengkap tanpa jenama kekal masuk penyebut. Semua sampel dirancang perlu sah dan dianalisis dengan kaedah serasi sebelum skor dan kedudukan dipaparkan. Pengumpulan tidak lengkap tidak diberi sifar, dan contoh sitasi 4/16 sebelumnya tidak memenuhi syarat pemerhatian untuk kedudukan GEO50.
Saranan kabur atau bertentangan mengekalkan penilaian tidak pasti, bukan andaian isyarat positif atau negatif. Kerana itu, skor merumuskan isyarat disahkan menurut dasar ini. Skor bukan tahap keyakinan, anggaran bahagian pasaran, atau penilaian kualiti produk.

Dasar penilaian GEO50 pada masa ini, diperiksa terhadap pelaksanaan. Pilihan pertama menambah pemberat pada saranan; isyarat kabur kekal tidak pasti. Ini bukan formula yang ditetapkan makalah rujukan. Lihat rajah saiz penuh.
Bandingkan pemerhatian dengan dasar yang sama
Skor lebih tinggi menjadi bermaklumat apabila perbandingan mengekalkan makna pengukuran. Protokol penyelidikan yang dicadangkan tinjauan menggabungkan pengukuran berulang, parafrasa, kawalan, dan pengesahan manusia. Tinjauan juga mencatat jawapan berkelompok menurut soalan, sumber, dan tarikh: menganggap setiap keluaran sebagai keutamaan pelanggan bebas boleh merendahkan anggaran ketidakpastian. Martinez
Untuk laporan perniagaan, simpan catatan perbandingan ringkas:
| Dimensi | Yang kekal dipaparkan |
|---|---|
| Soalan | Susunan tepat, maksud pelanggan, dan kaedah pemilihan |
| Keadaan | Platform, antara muka produk, bahasa, pasaran tujuan, dan masa |
| Sampel | Pemerhatian dirancang, boleh digunakan, dan gagal untuk setiap soalan dan platform |
| Perubahan | Versi halaman, tarikh intervensi, dan pembanding tanpa perlakuan jika boleh |
| Bukti | Jawapan asal, URL sumber, dan pemeriksaan penilaian automatik |
Gunakan ujian pendahuluan untuk menilai variasi dan memilih kedalaman sampel sesuai keputusan. Menambah jumlah tanpa menambah baik liputan soalan atau konsistensi pengumpulan kekal boleh menghasilkan kesimpulan menyesatkan. Kedudukan GEO50 pada masa ini tidak memaparkan selang keyakinan statistik atau membuktikan kesan kausal penyuntingan.
Gunakan kedudukan untuk menentukan apa yang perlu disiasat
Hasil lemah pada keperluan pelanggan relevan boleh mengarahkan perhatian ke fakta produk yang hilang, kedudukan tidak jelas, atau jawapan pesaing yang lebih kuat. Hasil lebih kuat boleh mengenal pasti penjelasan yang sesuai dikekalkan. Semak jawapan sebenarnya sebelum menentukan tindakan, dan bandingkan pemerhatian dengan kekal mengambil kira kumpulan soalan serta kaedah skornya.
Asingkan konteks perniagaan dari yang disahkan secara teknikal. Memilih pasaran menyatakan konteks pembelian tujuan; tidak automatik menghasilkan semula persekitaran pengguna tempatan. Trafik ciri AI Google termasuk dalam pelaporan Web keseluruhan di Search Console, sehingga jumlah keseluruhannya bukan kiraan sitasi AI tersendiri. Analitik laman dan soalan pelanggan menambah bukti hasil perniagaan. Google Search Central
GEO50 menunjukkan liputan pemerhatian dan kelengkapan pengumpulan, dan muat turun pada masa ini mengandungi kedudukan lengkap, bukan seluruh arkib jawapan. Gunakan untuk menemukan corak yang sesuai diperiksa, lalu ikuti bukti ke jawapan dan pengalaman pelanggan. Panduan persediaan laman menjelaskan cara mengubah dapatan menjadi penambahbaikan kandungan yang ditakrifkan.
Sumber dan catatan editorial
- Google Search Central — Ciri AI dan laman web anda ↗
Panduan rasmi Google AI Overviews dan AI Mode; diperiksa 18 Oktober 2026. Persyaratan platform, bukan kajian eksperimen.
- Schulte, Bleeker, dan Kaufmann — Jangan Mengukur Sekali Sahaja: Mengukur Keterlihatan dalam Carian AI (GEO) ↗
Pracetak 2026, arXiv v1, 8 April. Bahagian 3–6: pertindihan sumber/jenama secara longitudinal dan pada pengulangan di empat mesin. Konteks pengumpulan Swiss, sektor kempen terpilih, pengesanan jenama berasaskan substring, dan penyaringan mengehadkan generalisasi.
- Liu, Zhang, dan Liang — Menilai Kebolehsahan dalam Mesin Carian Generatif ↗
Findings of EMNLP 2023; arXiv v2, 23 Oktober 2023. Bahagian 2.3–2.4 dan 4.2, serta Batasan: liputan sitasi, ketepatan sitasi, dan perbezaan sokongan sumber dengan kebenaran fakta. Audit sejarah, bukan kartu nilai platform pada masa ini.
- Martinez — Mengoptimumkan Keterlihatan dalam Mesin Generatif: Tinjauan Kritis Pengoptimuman Mesin Generatif (2023–2026) ↗
Pracetak tinjauan 2026, arXiv v1, 15 Julai. Sintesis 45 kajian; Bahagian 3, 6, dan 11 membezakan tahap aliran, hasil keterlihatan, dan rancangan pengukuran. Gunakan sebagai sintesis penyelidikan, bukan pengesahan eksperimen bebas.
- Puerto dan rakan-rakan — C-SEO Bench: Adakah SEO Percakapan Berjaya? ↗
NeurIPS 2025, Datasets and Benchmarks Track. Bahagian 4 dan 6–7: dua tugasan, enam bidang, susunan sitasi, dan pesaing yang mengguna pakai kaedah. Tolok ukur berbahasa Inggeris; eksperimen susunan konteks tidak menunjukkan cara memperoleh susunan tersebut pada mesin yang beroperasi secara langsung.