ทำความเข้าใจคะแนน GEO: ตัวเลขบอกอะไรคุณได้บ้าง
เข้าใจว่าคะแนนการมองเห็นนับอะไร มีเสถียรภาพเพียงใด และงานวิจัยช่วยแยกอันดับที่สังเกตได้ออกจากข้อสรุปทางธุรกิจที่เชื่อถือได้อย่างไร

อัปเดต
อ่านคะแนน GEO โดยตรวจเหตุการณ์ที่มันนับ คำถามและตัวอย่างที่อยู่เบื้องหลัง และความแปรปรวนของคำตอบ การกล่าวถึง คำแนะนำ การอ้างอิง และการเข้าชมเป็นผลลัพธ์คนละอย่าง GEO50 รวมสัญญาณแบรนด์ที่ยืนยันได้เป็นอันดับสำหรับการสังเกตที่กำหนดขอบเขตไว้ การตีความความเปลี่ยนแปลงยังต้องอาศัยเงื่อนไขที่เปรียบเทียบกันได้และหลักฐานเบื้องหลัง
สิ่งที่ควรจำ
- ระบุเหตุการณ์และตัวหารก่อนเปรียบเทียบคะแนน
- ใช้คำตอบที่เก็บซ้ำและการตรวจแหล่งข้อมูลประเมินความเชื่อถือได้
- มองอันดับเป็นหลักฐานประกอบการตัดสินใจ ไม่ใช่เครื่องวัดคุณภาพผลิตภัณฑ์หรือผลของการแก้ไขที่พิสูจน์แล้ว
เริ่มจากการตัดสินใจที่คะแนนควรช่วยสนับสนุน
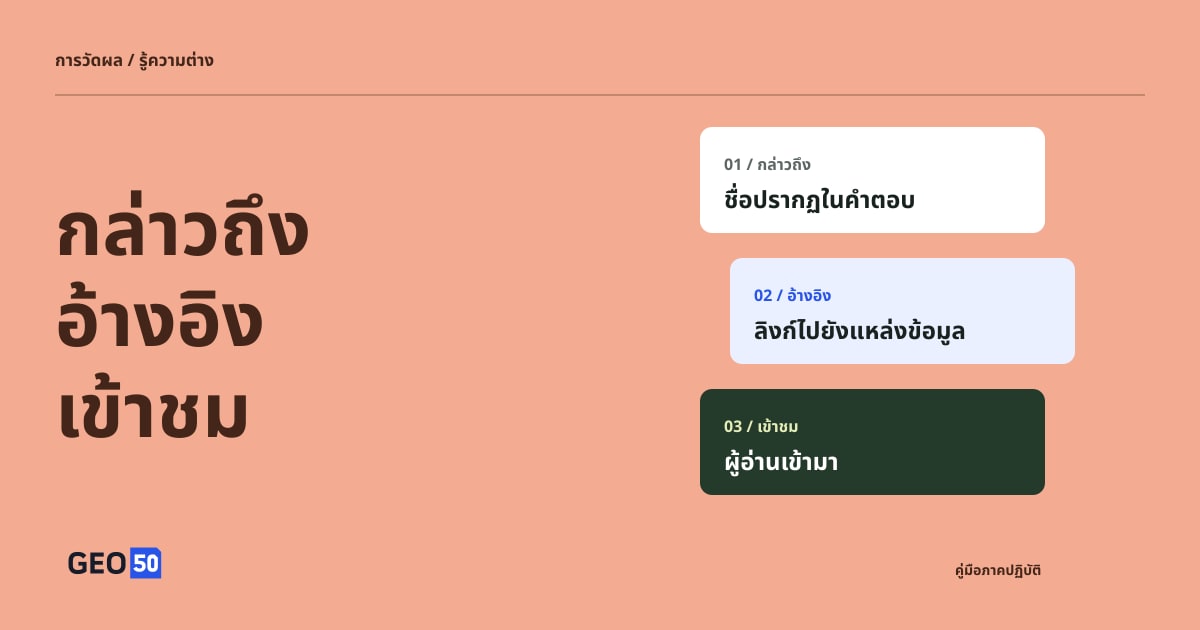
คะแนนของแบรนด์เพิ่มขึ้นหลังปรับเว็บไซต์ สิ่งที่อยากทำทันทีคือเรียกการปรับนั้นว่าประสบความสำเร็จ ก่อนทำเช่นนั้น ให้ถามว่าในคำตอบที่อยู่เบื้องหลังมีอะไรเปลี่ยนไป: แบรนด์ปรากฏบ่อยขึ้น ได้รับคำแนะนำที่หนักแน่นขึ้น หรือมีลิงก์ไปเว็บไซต์มากขึ้น? สิ่งเหล่านี้เป็นการปรับปรุงคนละแบบ
การวัดผลที่มีประโยชน์เริ่มจากคำถามอย่าง “คำตอบ AI ที่เกี่ยวข้องแนะนำผลิตภัณฑ์ของเราสำหรับความต้องการนี้ของลูกค้าหรือไม่?” คำถามกำหนดว่าจะเก็บพรอมป์ต์ใด นับเหตุการณ์ใด และการเปรียบเทียบใดมีความหมาย บทสำรวจเชิงวิพากษ์ปี 2026 ระบุเรื่องนี้ชัดเจน: กำหนดผลลัพธ์เป้าหมาย ตัวหาร และความต่างที่มีความหมายก่อนเก็บข้อมูล
แยกการปรากฏออกจากความชื่นชอบและการอ้างอิง
คำตอบที่ว่า “Acme เป็นหนึ่งในเครื่องมือจัดตารางนัดหมายหลายตัว” เป็นหลักฐานของการกล่าวถึง “Acme เป็นตัวเลือกที่เหมาะกับเอเจนซีนี้” เพิ่มคำแนะนำ ส่วน “Acme เป็นตัวเลือกแรกของฉันสำหรับข้อกำหนดเหล่านี้” แสดงความชื่นชอบที่มากกว่า ลิงก์แหล่งข้อมูลเป็นอีกเหตุการณ์หนึ่ง และอาจชี้ไปบริษัท รีวิวอิสระ หรือคู่แข่ง
| เหตุการณ์ | สิ่งที่หลักฐานต้องแสดง |
|---|---|
| การกล่าวถึง | มีการเอ่ยชื่อแบรนด์ในคำตอบ |
| คำแนะนำ | คำตอบเสนอแบรนด์เป็นตัวเลือกที่เหมาะสม |
| ตัวเลือกแรก | คำตอบระบุชัดว่าแบรนด์เป็นตัวเลือกอันดับหนึ่ง |
| การอ้างอิงเว็บไซต์ | ลิงก์ชี้ไปหน้าของบริษัทเอง |
ความแตกต่างนี้ยังอธิบายว่าทำไมจึงเปรียบเทียบผลวิจัยจากพาดหัวอย่างเดียวไม่ได้ C-SEO Bench ประเมินการเปลี่ยนลำดับการอ้างอิง ผลลัพธ์นั้นต่างจากความถี่ที่แบรนด์ถูกเอ่ยชื่อหรือแนะนำอย่างชัดเจน ในรายงานอัตโนมัติ ให้ตรวจตัวอย่างคำตอบต้นฉบับเพื่อดูว่าป้ายกำกับตรงกับภาษาที่ใช้หรือไม่ ชื่อแบรนด์ใน URL หรือการที่ผลิตภัณฑ์อยู่ลำดับแรกของรายการยังไม่เพียงพอที่จะยืนยันว่าเป็นคำแนะนำให้เลือกเป็นอันดับหนึ่งอย่างชัดเจน
ตรวจว่าการอ้างอิงสนับสนุนอะไรจริง
ลิงก์ทำให้ตรวจคำตอบได้ แต่ไม่ได้ยืนยันว่าหน้าที่ลิงก์ไปสนับสนุนข้ออ้างนั้น ในงานวิจัยเครื่องมือค้นหาที่สร้างคำตอบปี 2023 Liu, Zhang และ Liang ตรวจสอบ Bing Chat, NeevaAI, Perplexity และ YouChat ในระบบที่ประเมิน ข้อความที่สร้างขึ้น 51.5% มีการอ้างอิงสนับสนุนครบถ้วน ขณะที่การอ้างอิง 74.5% สนับสนุนข้อความที่ผูกอยู่ ตัวเลขเหล่านี้เป็นผลตรวจสอบในอดีต ไม่ใช่ค่าประมาณความแม่นยำของแพลตฟอร์มในปัจจุบัน
ตัวเลขสองตัวตอบคนละคำถาม ความครอบคลุมการอ้างอิงพิจารณาว่าข้อความที่ต้องตรวจสอบมีแหล่งสนับสนุนครบหรือไม่ ความแม่นยำการอ้างอิงพิจารณาว่าการอ้างอิงที่แนบมาสนับสนุนสิ่งที่คำตอบกล่าวหรือไม่ ทั้งคู่ต้องตรวจแหล่งข้อมูล ไม่ใช่นับลิงก์
สมมติว่าคำตอบระบุว่าผลิตภัณฑ์ใช้งานออฟไลน์ได้และมีบริการเริ่มใช้งานฟรี หน้าเว็บที่ยืนยันการใช้ออฟไลน์รองรับเพียงบางส่วนของประโยคนั้น ตรวจข้ออ้างอีกส่วน แพ็กเกจที่ใช้ได้ และวันที่ ก่อนถือว่าคำตอบถูกต้อง แม้มีแหล่งสนับสนุนครบ ก็เป็นการทดสอบความตรงกันของการอ้างที่มา ไม่ใช่ข้อพิสูจน์ว่าแหล่งข้อมูลนั้นเป็นจริง สำหรับธุรกิจ การตรวจที่นำไปใช้ได้คือความสามารถและเงื่อนไขของตนยังคงอยู่ในการเล่าต่อหรือไม่
แสดงตัวหารให้เห็น
สมมติว่าพยายามเก็บข้อมูล 20 ครั้ง ได้คำตอบที่ใช้ได้ 16 คำตอบ และสี่คำตอบอ้างอิงเว็บไซต์บริษัท อัตราอ้างอิงในคำตอบที่ใช้ได้คือ 4/16 หรือ 25%; ความสำเร็จในการเก็บข้อมูลคือ 16/20 หรือ 80% ตัวเลขสมมติเหล่านี้อธิบายคนละเรื่อง การรายงานเพียง “การมองเห็น 25%” ซ่อนความล้มเหลวในการเก็บข้อมูลและไม่ระบุว่ากำลังนับเหตุการณ์ใด
คำตอบที่เสร็จสมบูรณ์แต่ไม่มีการกล่าวถึงแบรนด์ก็ต่างจากคำขอที่ล้มเหลว อย่างแรกคือการไม่ปรากฏที่สังเกตได้ อย่างหลังคือหลักฐานที่ขาดหาย บันทึกแยกกันและระบุว่าข้อสังเกตใดเข้าสู่ตัวชี้วัดแต่ละตัว
การเลือกคำถามสำคัญไม่แพ้กัน “Acme เป็นเครื่องมือจัดตารางนัดหมายที่ดีหรือไม่?” ทดสอบการตอบสนองต่อแบรนด์ที่ระบุชื่อ ส่วน “เครื่องมือใดเหมาะกับเอเจนซีขนาดเล็ก?” ทดสอบการค้นพบภายในหมวดหมู่ การปะปนโดยไม่แยกอาจเปลี่ยนคะแนนเพียงเพราะเปลี่ยนคำถาม คำถามที่สร้างขึ้นเป็นชุดทดสอบ ไม่ได้วัดว่าลูกค้าจริงถามแต่ละคำถามบ่อยเพียงใด
คาดหวังความแปรปรวนระหว่างคำตอบ
Don’t Measure Once ซึ่งเป็นต้นฉบับก่อนตีพิมพ์ปี 2026 ศึกษาเครื่องมือค้นหา AI สี่ตัวโดยใช้ข้อสังเกตตามเวลาและการรันซ้ำ ในการวิเคราะห์แหล่งข้อมูลภายใน 24 ชั่วโมง ค่าเฉลี่ยการทับซ้อน Jaccard อยู่ระหว่างประมาณ 32% ถึง 43% ในสี่หมวดหมู่แคมเปญ Jaccard เปรียบเทียบแหล่งที่ใช้ร่วมกันกับยูเนียนของแหล่งข้อมูลสองชุด ไม่ใช่อัตราการกล่าวถึงแบรนด์หรือความน่าจะเป็นที่คำตอบถูกต้อง
การวิเคราะห์ใช้การทำซ้ำสูงสุดสิบครั้งต่อคู่เครื่องมือ–พรอมป์ต์ และตัดการรันที่สกัดการอ้างอิงไม่ได้ออกจากการเปรียบเทียบแหล่งข้อมูลนั้น บริบทการเก็บข้อมูลเป็นสวิตเซอร์แลนด์ และสาขาที่เลือกกับกฎตรวจจับแบรนด์จำกัดการนำผลไปใช้ทั่วไปเพิ่มเติม ข้อค้นพบที่มีประโยชน์คือคำตอบครั้งที่สองอาจแตกต่างมากแม้เวลาไม่ได้ห่างนานหรือไม่มีการแก้เว็บไซต์
จึงควรตรวจสามเรื่องแยกกัน: ถามคำถามเดิมซ้ำเพื่อดูความแปรปรวนแต่ละรอบ ใช้ถ้อยคำที่มีความหมายเทียบเท่ากันเพื่อดูความไวต่อการใช้คำ และเก็บชุดคำถามคงที่ซ้ำตามเวลาเพื่อดูการเปลี่ยนแปลง ผลที่คงอยู่ผ่านการตรวจทั้งสามมีข้อมูลมากกว่าภาพหน้าจอที่เป็นผลดีเพียงภาพเดียว
GEO50 เปลี่ยนสัญญาณแบรนด์เป็นคะแนนอย่างไร
GEO50 สรุปสัญญาณแบรนด์ที่ยืนยันได้ในตัวอย่างคำตอบ AI แบบถามตอบรอบเดียว สูตรปัจจุบันเป็นนโยบายให้คะแนนของเรา ไม่ใช่สูตรที่งานวิจัยที่อ้างในที่นี้กำหนด การอ้างอิงเว็บไซต์ การเข้าชมจากแหล่งอ้างอิง และคุณภาพการอ้างอิงอยู่นอกคะแนนนี้
| สัญญาณ | ส่วนที่นำมาคิดคะแนน |
|---|---|
| แบรนด์ปรากฏในคำตอบ | 20 × อัตราการกล่าวถึง |
| แบรนด์ได้รับคำแนะนำอย่างชัดเจน | 50 × อัตราการแนะนำ |
| แบรนด์เป็นตัวเลือกแรกอย่างชัดเจน | 30 × อัตราการเป็นตัวเลือกแรก |
| แบรนด์ถูกระบุชัดว่าไม่แนะนำ | −50 × อัตราการไม่แนะนำ |
ใช้อัตราตั้งแต่ 0 ถึง 1 รวมส่วนต่าง ๆ แล้วจำกัดผลไว้ที่ 0–100 ตัวเลือกแรกเป็นส่วนหนึ่งของคำแนะนำและได้รับน้ำหนักเพิ่ม ลำดับรายการ ตัวหนา หรือการกล่าวซ้ำเพียงอย่างเดียวไม่ยืนยันการเป็นตัวเลือกแรก และหลายผลิตภัณฑ์จากแบรนด์เดียวกันในคำตอบหนึ่งไม่ทำให้ได้คะแนนเพิ่ม
ในคำตอบสมมติสิบคำตอบที่มีน้ำหนักเท่ากัน แบรนด์ที่ถูกกล่าวถึงอย่างเป็นกลางครบสิบคำตอบได้ 20 คะแนน แบรนด์ที่ถูกแนะนำในสามคำตอบ ไม่ปรากฏในเจ็ดคำตอบ และไม่เคยถูกระบุเป็นตัวเลือกแรก ได้ 21 คะแนน: 20 × 0.3 + 50 × 0.3 ความต่างสะท้อนการให้น้ำหนักคำแนะนำของนโยบายคะแนน ไม่ใช่ความน่าจะเป็นในการซื้อของตัวเลขใดตัวเลขหนึ่ง
ตัวอย่างที่เก็บซ้ำจะเฉลี่ยภายในแต่ละคู่คำถาม–แพลตฟอร์ม แล้วให้แต่ละคู่มีน้ำหนักเท่ากัน คำตอบที่สมบูรณ์และไม่เอ่ยชื่อแบรนด์ใดยังคงอยู่ในตัวหาร ตัวอย่างที่วางแผนทั้งหมดต้องใช้ได้และวิเคราะห์ด้วยวิธีที่เข้ากันก่อนแสดงคะแนนและอันดับ การเก็บข้อมูลที่ไม่ครบจะไม่ถูกให้คะแนนศูนย์ และตัวอย่างการอ้างอิง 4/16 ก่อนหน้านี้ไม่ได้ทำให้ชุดการสังเกตผ่านเกณฑ์จัดอันดับ GEO50
คำแนะนำที่คลุมเครือหรือขัดแย้งจะคงสถานะไม่แน่ชัดไว้ แทนการสมมติว่าเป็นสัญญาณบวกหรือลบ คะแนนจึงสรุปสัญญาณที่ยืนยันได้ภายใต้นโยบายนี้ ไม่ใช่ระดับความเชื่อมั่น ค่าประมาณส่วนแบ่งตลาด หรือคะแนนคุณภาพผลิตภัณฑ์

นโยบายคะแนนปัจจุบันของ GEO50 ตรวจสอบเทียบกับการทำงานจริงแล้ว ตัวเลือกแรกเพิ่มน้ำหนักให้คำแนะนำ ส่วนสัญญาณคลุมเครือยังคงไม่แน่ชัด นี่ไม่ใช่สูตรที่งานวิจัยที่อ้างอิงกำหนด ดูแผนภาพขนาดเต็ม
เปรียบเทียบการสังเกตด้วยเงื่อนไขเดียวกัน
คะแนนที่สูงขึ้นมีข้อมูลเมื่อการเปรียบเทียบยังรักษาความหมายของการวัดไว้ ระเบียบวิธีวิจัยที่บทสำรวจเสนอรวมการวัดซ้ำ การถอดความ กลุ่มควบคุม และการยืนยันโดยมนุษย์ อีกทั้งชี้ว่าคำตอบจับกลุ่มตามคำถาม แหล่งข้อมูล และวันที่ การมองทุกผลลัพธ์เป็นความชื่นชอบของลูกค้าที่เป็นอิสระจากกันอาจทำให้ประเมินความไม่แน่นอนต่ำเกินไป Martinez
สำหรับรายงานธุรกิจ ให้เก็บบันทึกเปรียบเทียบแบบกระชับ:
| มิติ | สิ่งที่ควรแสดงให้เห็น |
|---|---|
| คำถาม | ถ้อยคำตรงตัว เจตนาลูกค้า และวิธีเลือก |
| เงื่อนไข | แพลตฟอร์ม ช่องทางผลิตภัณฑ์ ภาษา ตลาดเป้าหมาย และเวลา |
| ตัวอย่าง | จำนวนที่วางแผน ใช้ได้ และล้มเหลวของแต่ละคำถามและแพลตฟอร์ม |
| การเปลี่ยนแปลง | เวอร์ชันหน้าเว็บ วันที่ปรับ และกลุ่มเปรียบเทียบที่ไม่ปรับเมื่อทำได้ |
| หลักฐาน | คำตอบต้นฉบับ URL แหล่งข้อมูล และการตรวจคำตัดสินอัตโนมัติ |
ใช้การทดลองนำร่องประเมินความแปรปรวนและเลือกระดับความลึกของการสุ่มตัวอย่างให้เหมาะกับการตัดสินใจ การเพิ่มจำนวนโดยไม่ปรับความครอบคลุมคำถามหรือความสม่ำเสมอของการเก็บข้อมูลยังอาจให้ผลที่ชวนเข้าใจผิด อันดับปัจจุบันของ GEO50 ไม่แสดงช่วงความเชื่อมั่นทางสถิติและไม่ยืนยันผลเชิงสาเหตุของการแก้ไข
ใช้อันดับตัดสินใจว่าจะตรวจสอบอะไร
ผลที่อ่อนสำหรับความต้องการที่เกี่ยวข้องของลูกค้าอาจชี้ให้สนใจข้อเท็จจริงผลิตภัณฑ์ที่ขาด การวางตำแหน่งที่ไม่ชัด หรือคำตอบคู่แข่งที่แข็งแรงกว่า ผลที่ดีขึ้นอาจชี้ถึงคำอธิบายที่ควรรักษาไว้ ตรวจคำตอบจริงก่อนตัดสินใจทำสิ่งต่อไป และเปรียบเทียบการสังเกตโดยคำนึงถึงชุดคำถามและวิธีให้คะแนน
แยกบริบทธุรกิจออกจากสิ่งที่ยืนยันทางเทคนิคแล้ว การเลือกตลาดแสดงบริบทการซื้อที่ตั้งใจ แต่ไม่ได้จำลองสภาพแวดล้อมของผู้ใช้ในพื้นที่นั้นโดยตัวมันเอง ทราฟฟิกฟีเจอร์ AI ของ Google รวมอยู่ในรายงาน Web โดยรวมของ Search Console ดังนั้นยอดรวมนั้นไม่ใช่จำนวนการอ้างอิง AI ที่แยกเฉพาะ การวิเคราะห์เว็บไซต์และการติดต่อของลูกค้าเพิ่มหลักฐานอีกส่วนเกี่ยวกับผลลัพธ์ธุรกิจ Google Search Central
GEO50 แสดงขอบเขตการสังเกตและความครบถ้วนของการเก็บข้อมูล และไฟล์ดาวน์โหลดปัจจุบันมีอันดับที่เสร็จสมบูรณ์ ไม่ใช่คลังคำตอบทั้งหมด ใช้มันค้นหารูปแบบที่ควรตรวจ แล้วติดตามหลักฐานไปยังคำตอบและประสบการณ์ลูกค้า คู่มือเตรียมเว็บไซต์ ของเราอธิบายวิธีเปลี่ยนข้อค้นพบเป็นการปรับเนื้อหาที่มีขอบเขตชัดเจน
แหล่งข้อมูลและหมายเหตุบรรณาธิการ
- Google Search Central — ฟีเจอร์ AI และเว็บไซต์ของคุณ ↗
คำแนะนำอย่างเป็นทางการสำหรับ Google AI Overviews และ AI Mode; ตรวจสอบวันที่ 18 ตุลาคม 2026 เป็นข้อกำหนดของแพลตฟอร์ม ไม่ใช่งานวิจัยเชิงทดลอง
- Schulte, Bleeker และ Kaufmann — อย่าวัดเพียงครั้งเดียว: การวัดการมองเห็นในการค้นหาด้วย AI (GEO) ↗
ต้นฉบับก่อนตีพิมพ์ปี 2026, arXiv v1 วันที่ 8 เมษายน ส่วนที่ 3–6: การทับซ้อนของแหล่งข้อมูล/แบรนด์ตามเวลาและการรันซ้ำในสี่เครื่องมือ บริบทการเก็บข้อมูลในสวิตเซอร์แลนด์ หมวดแคมเปญที่เลือก การตรวจจับแบรนด์ด้วยสตริงย่อย และการกรองจำกัดการนำผลไปใช้ทั่วไป
- Liu, Zhang และ Liang — การประเมินความสามารถในการตรวจสอบของเครื่องมือค้นหาที่สร้างคำตอบ ↗
Findings of EMNLP 2023; arXiv v2 วันที่ 23 ตุลาคม 2023 ส่วนที่ 2.3–2.4 และ 4.2 รวมถึงข้อจำกัด: ความครอบคลุมการอ้างอิง ความแม่นยำการอ้างอิง และความต่างระหว่างการมีแหล่งสนับสนุนกับความจริงเชิงข้อเท็จจริง เป็นการตรวจสอบในอดีต ไม่ใช่ตารางคะแนนแพลตฟอร์มปัจจุบัน
- Martinez — การปรับการมองเห็นในเครื่องมือสร้างคำตอบ: บทสำรวจเชิงวิพากษ์การปรับให้เหมาะกับเครื่องมือสร้างคำตอบ (2023–2026) ↗
ต้นฉบับบทสำรวจปี 2026, arXiv v1 วันที่ 15 กรกฎาคม สังเคราะห์งานวิจัย 45 ชิ้น; ส่วนที่ 3, 6 และ 11 แยกขั้นตอนในกระบวนการ ผลลัพธ์ด้านการมองเห็น และการออกแบบการวัดผล ใช้เป็นการสังเคราะห์งานวิจัย ไม่ใช่หลักฐานยืนยันจากการทดลองอิสระ
- Puerto และคณะ — C-SEO Bench: SEO สำหรับการสนทนาได้ผลหรือไม่? ↗
NeurIPS 2025 สาขา Datasets and Benchmarks ส่วนที่ 4 และ 6–7: สองงาน หกสาขา อันดับการอ้างอิง และคู่แข่งที่ใช้วิธีเดียวกัน เป็นเบนช์มาร์กภาษาอังกฤษ การทดลองลำดับบริบทไม่ได้แสดงวิธีทำให้ได้ลำดับนั้นบนเครื่องมือที่ให้บริการจริง